要点
- ChatGPTやGeminiなど主要AIエンジンで日本語回答を個別に追跡できるのは、言語・市場ごとのセグメント計測機能を持つツールに限られます。
- 外資系日本法人がAI検索での競合優位性の原因を特定するには、引用元ドメインと推薦ロジックを可視化できるツールが鍵です。
- 日本語と英語のAI回答を横断比較するには、多言語・多市場トラッキングを単一ダッシュボードで提供するプラットフォームが必要です。
LLMO(LLM最適化)とは、ChatGPTやGemini、Perplexityなどの生成AIが回答を生成する際に、自社ブランドが正確に・かつ優先的に引用・推薦されるよう最適化する取り組みです。AEO(Answer Engine Optimization)やGEO(Generative Engine Optimization)とも呼ばれますが、日本のマーケターが実際に検索するのは「LLMO」という表現が多い傾向にあります。
日本市場でこの課題が特に複雑なのは、言語の壁だけが理由ではありません。ChatGPTとGeminiでは日本語の引用元として参照するドメインの傾向が異なり、同一プロンプトでも推薦されるブランドが変わります。外資系日本法人にとっては「なぜ国内競合ばかり推薦されるのか」という問いに対して、エンジンごとの引用元を可視化しなければ答えが出ません。本ガイドでは、日本語AI検索のブランド計測に必要な機能要件から、ツール選定の判断軸、ユースケース別のフレームワークまでを整理します。
日本語AI検索のブランド計測:まず確認すべき機能要件
最初に確認すべきは、日本語プロンプトを個別に設定できるか、そして言語・市場単位で結果を分離表示できるかの2点です。
グローバルなLLMOツールの多くは英語圏を前提に設計されており、「日本語対応」とうたっていてもUIが英語のままか、日本語プロンプトを一括追加する機能がないケースがあります。実際に日本語で「〇〇の比較をしてください」と入力したときのChatGPTとGeminiの回答が、どのような構造でどのURLを引用しているかを記録できなければ、計測として機能しません。
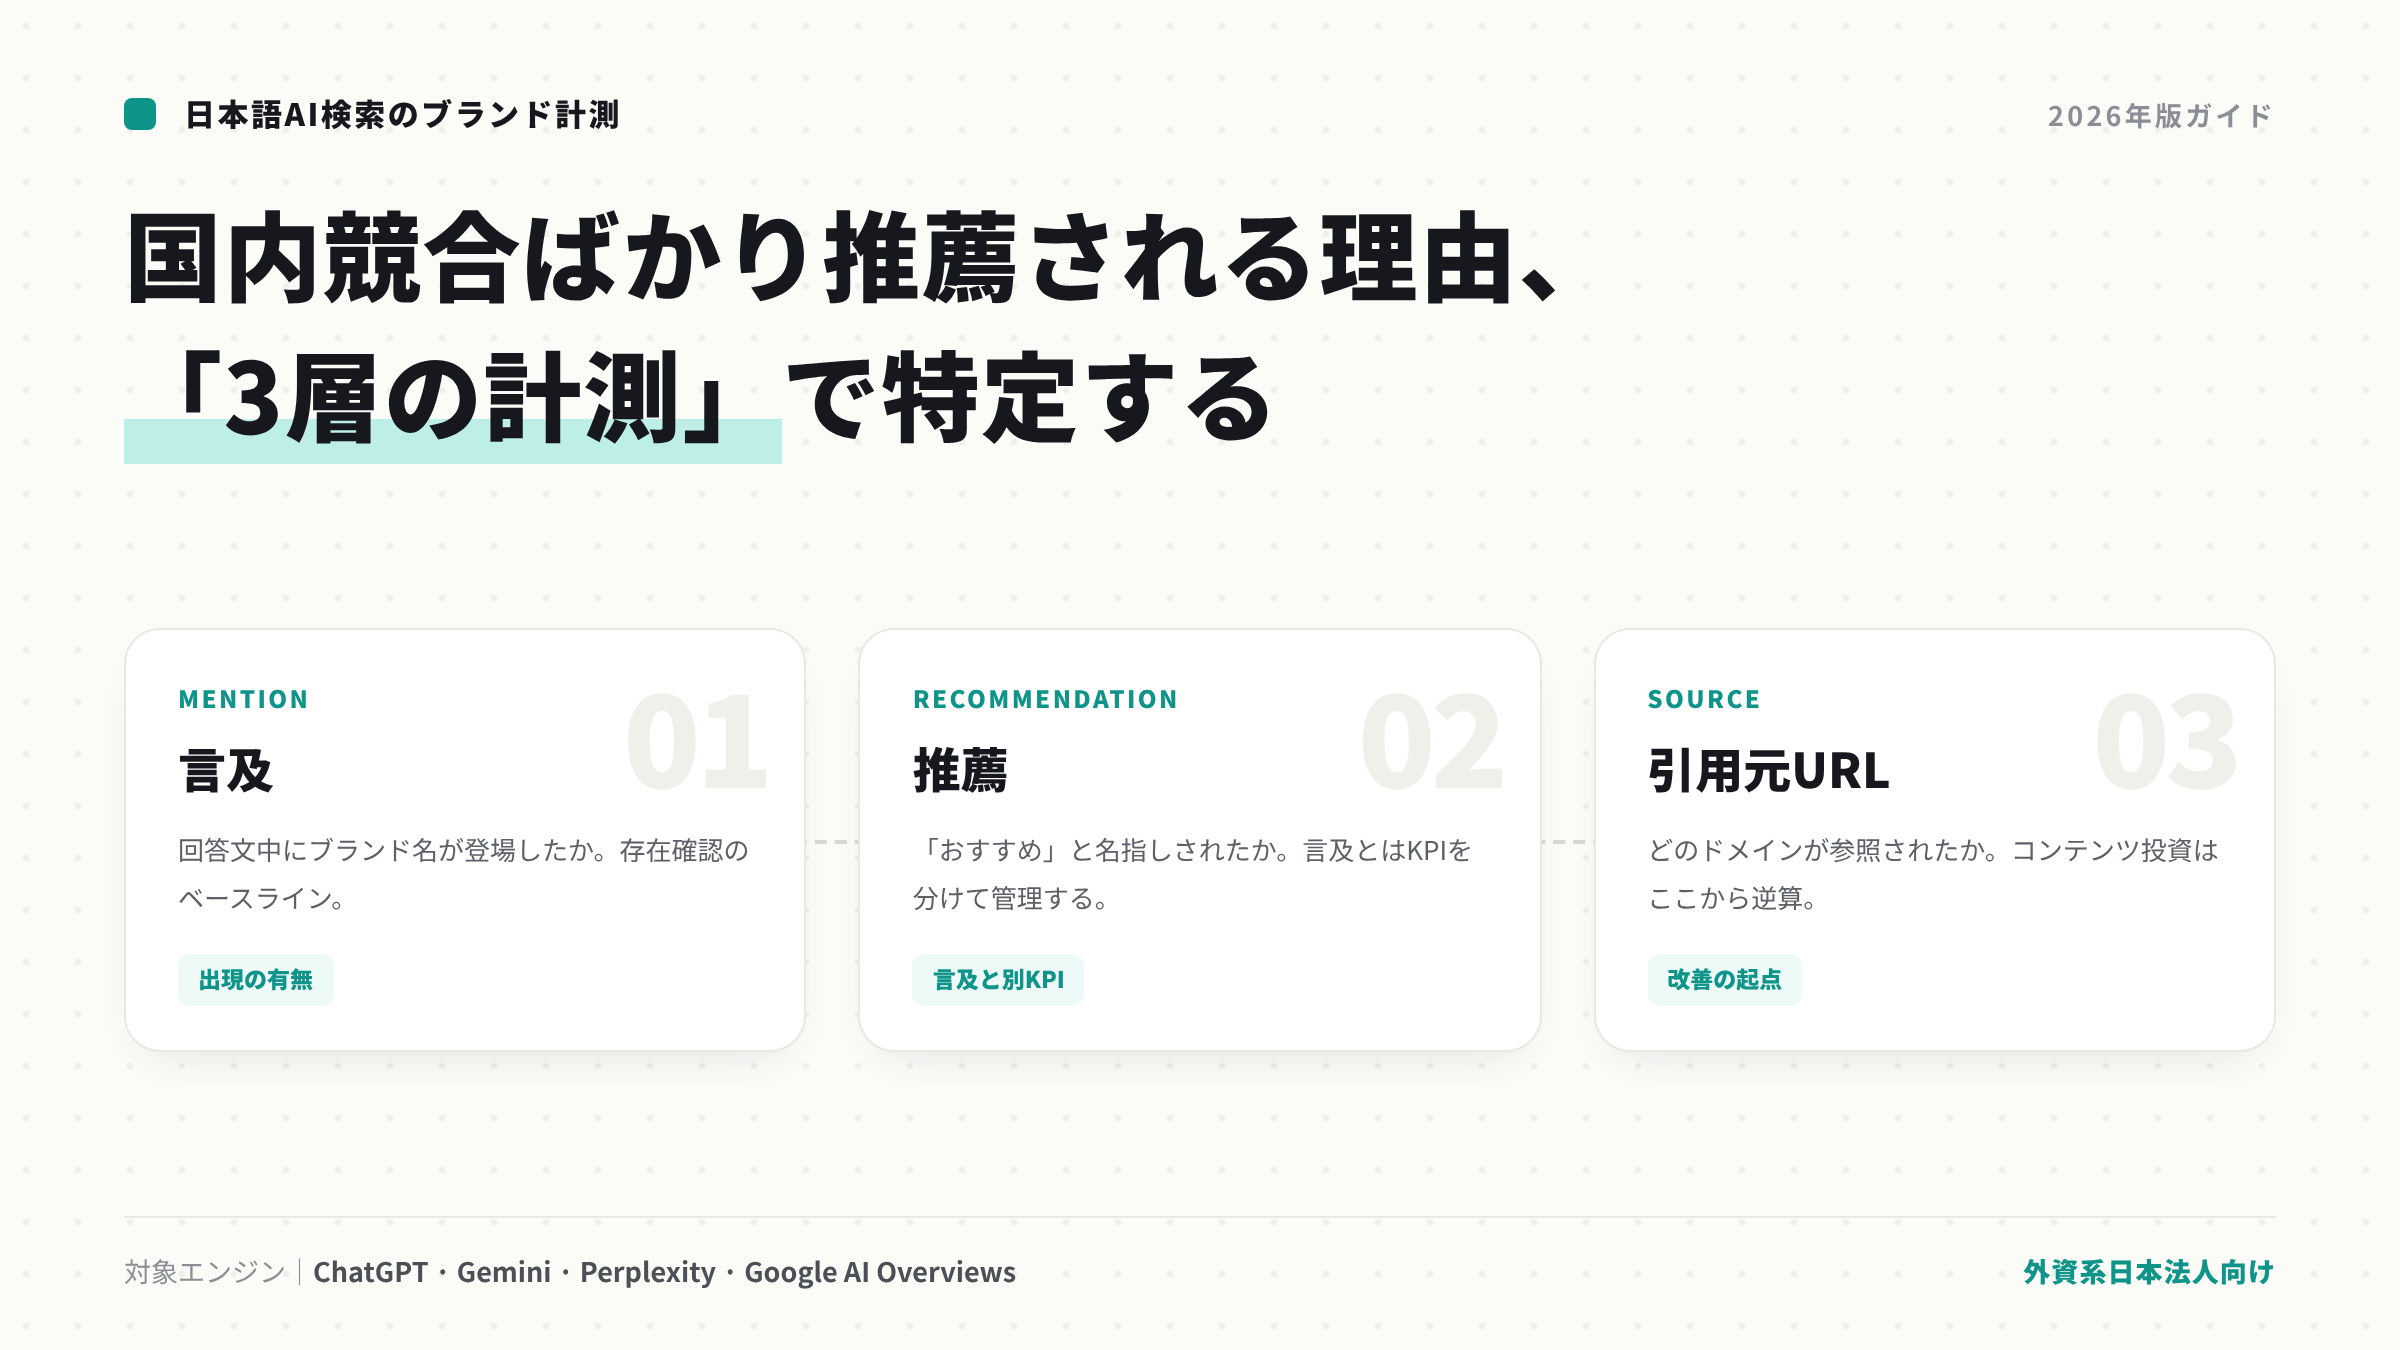
計測指標は3層で考えると整理しやすくなります。まず「言及(mention)」、次に「推薦(recommendation)」、そして「引用元URL」です。ブランド名が回答文中に登場するだけの言及と、「〇〇がおすすめです」という形で名指しされる推薦は、KPIとして分けて管理する必要があります。この区別ができないツールでは、AI回答でのブランドの存在感を過大評価したり過小評価したりするリスクがあります。
引用元URLの可視化は、特に外資系日本法人にとって重要な機能です。国内競合がAI回答で優先されている場合、その競合がどのサイトから引用されているかを特定できれば、どのメディアや比較サイトへの掲載を優先すべきかが明確になります。感覚論ではなく、データに基づいたコンテンツ投資の判断が可能になるのです。
実務上しばしば軽視されるのが「英語レポート出力」の有無です。外資系日本法人がグローバル本社にAI検索での状況を報告する際、日本語ダッシュボードのスクリーンショットを送っても議論が成立しません。日英両言語での出力、または自動翻訳レポート機能は、選定条件として明示的にチェックリストに加えるべき項目です。
競合ブランドの自動検出も必須です。AI回答内に登場するブランドはあらかじめすべて把握できているわけではなく、特に進出初期のグローバルブランドは「想定外の競合」が推薦されることが少なくありません。ツールが新たな競合候補を自動的に通知する仕組みを持っているかどうかは、モニタリングの網羅性に直結します。
主要AIエンジンの日本語対応状況と追跡対象の選び方
2026年時点で日本市場への影響が大きいAIエンジンは、ChatGPT、Google Gemini、Perplexity、Google AI Overviewsの4つが中心です。優先度はユーザーの検索行動に依存しますが、この4つを抑えておけばカバレッジとしては現時点で十分です。
エンジンごとの挙動の違いは想像以上に大きいものです。同じ「日本でおすすめのプロジェクト管理ツールは?」というプロンプトをChatGPTとPerplexityに投げると、引用するドメインも推薦順位も異なる結果が返ってくることが多くあります。ChatGPTはモデルに蓄積された学習知識を基に回答を生成することもありますが、Search機能が有効な状態ではリアルタイムの検索結果を引用します。Perplexityは原則としてウェブ検索結果を引用するため、引用URLが明示されます。Geminiは自社のインデックスを持つGoogleのエコシステムに近い構造です。こうした違いを理解したうえで、エンジン別にブランドの出現状況を分けて記録することが計測の基本です。
Google AI Overviewsは日本語検索での影響が急速に拡大しており、従来のSEOツールだけでは十分に追跡できません。オーガニック検索結果の上部にAIが生成した回答ブロックが表示される形式で、ユーザーがそこで満足してしまうとその下の検索結果には到達しません。SEOのKPIとは別に、AI OverviewsでのShare of Voiceを計測する枠組みが必要になっています。
国内競合ばかりが推薦される原因は多くの場合、AIが参照する日本語コンテンツの量と質にあります。ITmedia、価格.com、Qiitaといった日本語メディア・Q&Aサイトでの言及数と、それらがどのAIエンジンにどの頻度で引用されているかを確認することが、競合分析の出発点です。追跡対象エンジンを選ぶ際は、自社の顧客層が日常的に使うAIツールから逆算するのが最も実用的な方法です。
ツール評価の7つの判断軸:日本市場向けチェックリスト
日本市場向けにLLMO(AEO/GEO)ツールを選定する際の判断軸を7つに整理しました。この順序は重要度の目安でもあります。
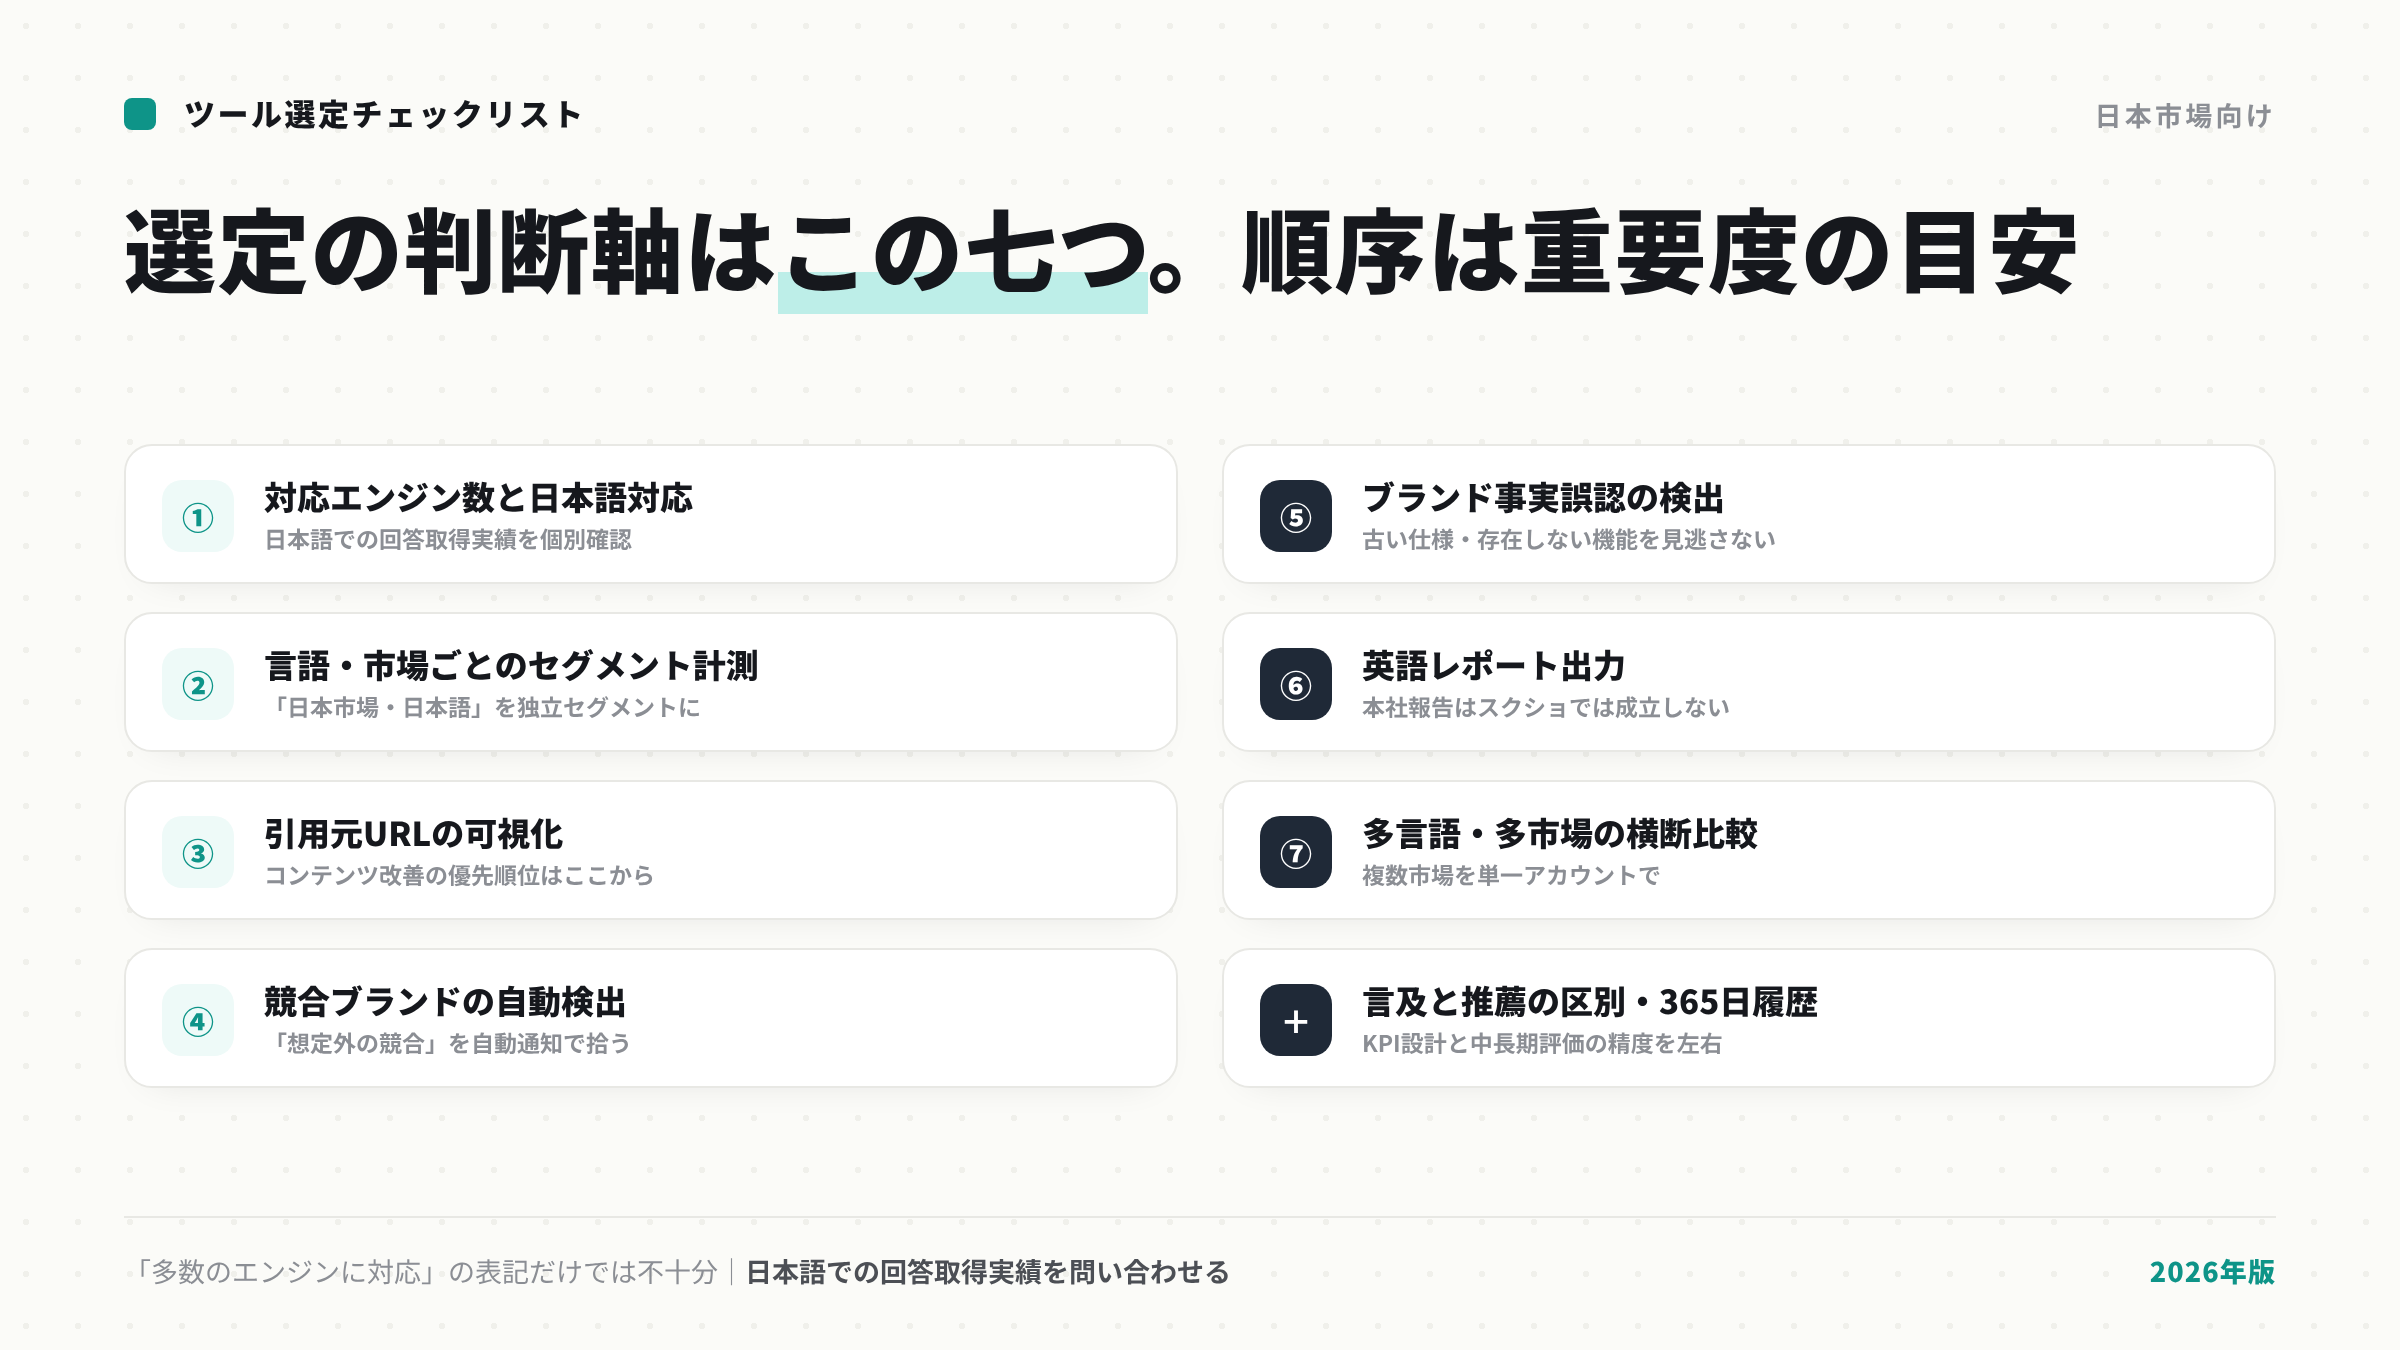
① 対応AIエンジン数と日本語エンジンの有無
ChatGPT・Gemini・Perplexity・Google AI Overviewsをカバーしているかを個別に確認する必要があります。「多数のエンジンに対応」という表記だけでは不十分で、日本語での回答取得実績があるかどうかを問い合わせるのが確実です。
② 言語・市場ごとのセグメント計測
日本語の結果と英語の結果を同一ダッシュボードで並べて比較できるかどうかが重要です。単に多言語対応しているだけでは不十分で、「日本市場・日本語」という組み合わせを独立したセグメントとして扱えることが条件です。
③ 引用元URLの可視化
AIが回答を生成した際にどのURLを参照・引用したかを記録し、競合と自社の引用元を比較できるか確認します。この機能がなければコンテンツ改善の優先順位が立てられません。
④ 競合ブランドの自動検出
AI回答内に登場した新規競合候補を自動的に通知する仕組みがあるかどうかを調べます。手動設定だけでは見落としが生じます。
⑤ ブランド事実誤認の検出
AIが自社について誤った情報(古い仕様、存在しない機能など)を回答している場合に検出できるかを確認します。これを見逃すと顧客の意思決定に誤情報が混入するリスクがあります。
⑥ 英語レポート出力
外資系日本法人が本社に報告する際に必要な機能です。日本語ダッシュボードのみでは本社との議論が成立しないケースが多くあります。
⑦ 多言語・多市場の横断比較
日本・米国・欧州など複数市場を単一アカウントで管理し、同一プロンプトの言語別回答を比較できるか確認します。グローバル企業の運用においては組織効率に直結します。
「言及」と「推薦」を区別してカウントできるツールは市場全体でも限られており、この機能の有無がKPI設計の精度を左右します。365日以上の履歴保存が可能かどうかも、中長期の施策効果を評価する際に重要な条件です。
ユースケース別ツール選定フレームワーク
ユースケースを4つのシナリオに分けて、それぞれに必要な機能セットを整理します。
シナリオ①:海外ブランドの日本進出フェーズ
進出初期で最も必要なのは「市場ベースライン」の把握です。AIがどの競合ブランドをどの頻度で推薦しているか、どの日本語ドメインが主に引用されているか、これらを最初の2〜4週間で把握できるかどうかが出発点です。この段階では初期設定のしやすさと、競合の自動検出・引用元可視化が優先機能になります。ツールの多言語プロンプト設定が直感的かどうかも、立ち上げコストに大きく影響します。
シナリオ②:外資系日本法人の継続モニタリング
定常運用では「ブランド情報のファクトチェック」と「引用元の改善提案」が差別化ポイントになります。AIが自社について誤った情報を回答し続けるリスクは、時間が経つほど蓄積されます。週次または月次でブランド情報のファクトチェックを自動実行し、誤情報が検出されたら引用元コンテンツの修正につなげるワークフローを組み込めるかどうかで、ツールの実務価値は大きく変わります。
シナリオ③:本社への多言語レポーティング
グローバル本社に対して日本市場でのAI検索状況を英語で定期報告する場合、日英の結果を同一ダッシュボードで比較できる構造が前提になります。レポートの自動生成・翻訳機能があると実務負荷が大幅に下がります。たとえばCitadexの成果レポートは、英語を含む34言語からレポート言語を選んで作成できます。本社とローカルチームが同じデータを参照しながら議論できることが、組織全体としての意思決定スピードに直結します。
シナリオ④:代理店・エージェンシーによるクライアント管理
複数クライアントを抱えるエージェンシーは、クライアントごとにデータが完全に分離されていること、ホワイトラベル対応があること、この2点を必ず確認します。クライアントのプロジェクト間でプロンプト・競合設定・引用元データが混在しない構造が、報告の信頼性と業務管理の効率を両立させる条件です。Citadexの代理店向けプランは、クライアントごとに独立したプロジェクトとして管理し、完全なホワイトラベル機能を提供しています(citadex.io/about)。
AIが自社ブランドを誤って紹介する問題:検出から修正までの流れ
AIが自社ブランドの情報を誤って回答する問題は、LLMOツールの「ブランド情報のファクトチェック」機能を使って定期的に検出することが第一ステップです。誤情報のパターンは存在しない仕様・機能の記載、撤退済みの製品ラインへの言及、現在とは異なる価格・料金体系の提示の3種類に分けられます。どれも顧客の購買判断に直接影響するため、放置コストは高いものです。
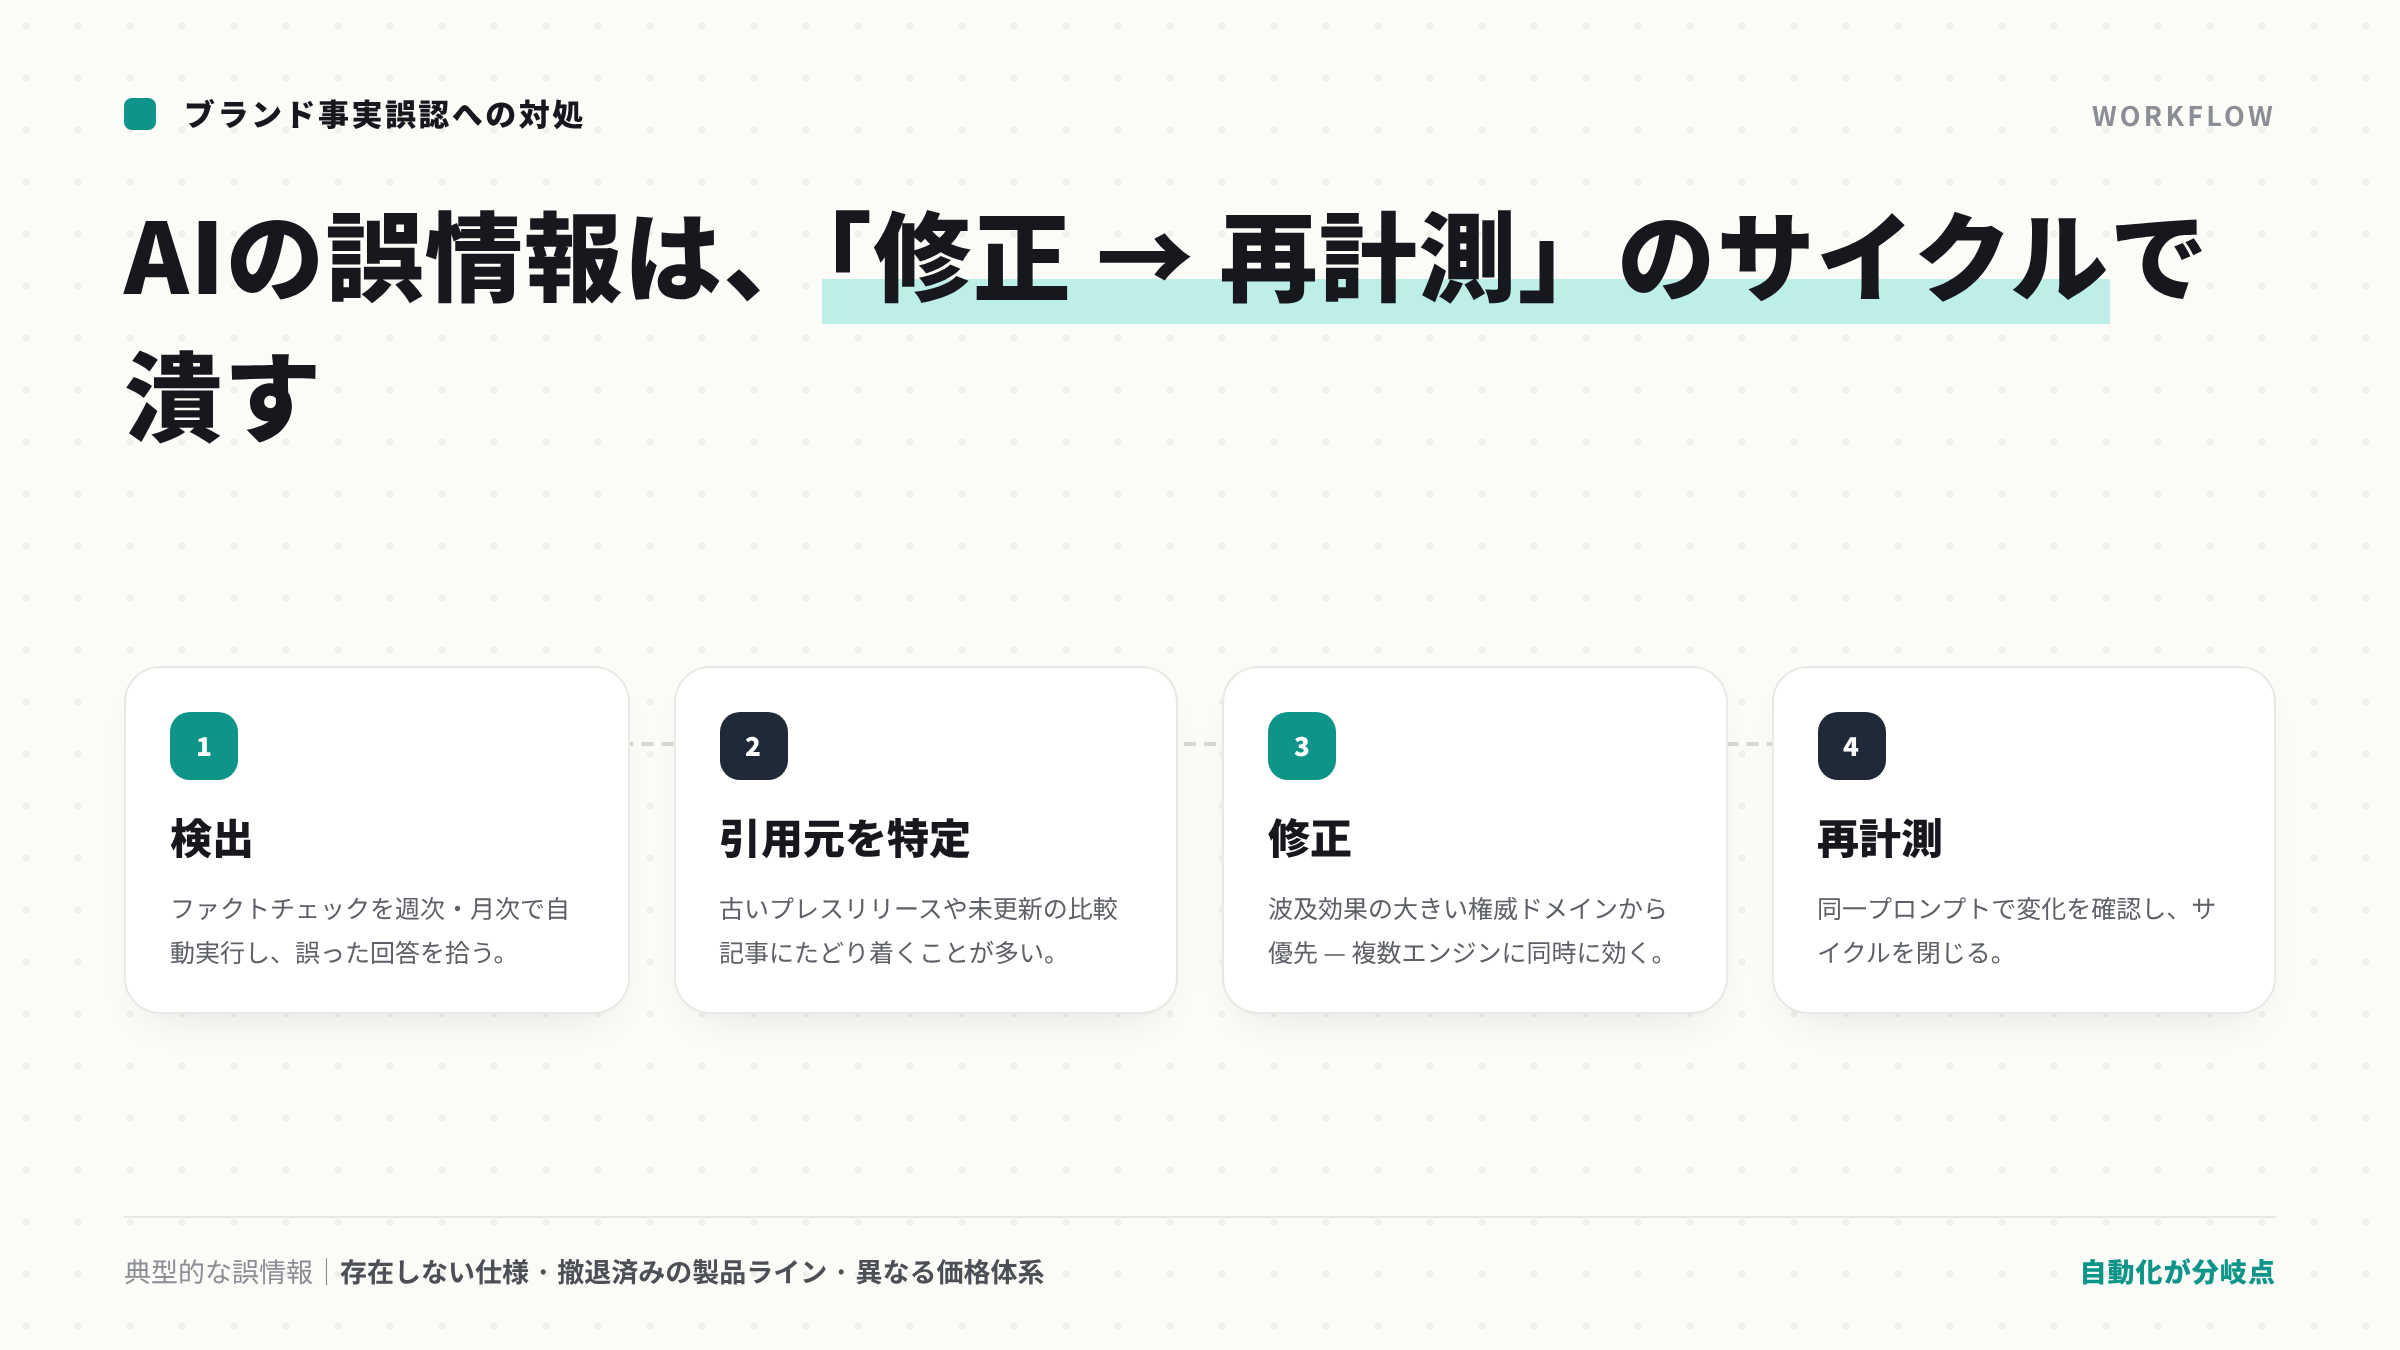
誤情報の発生源を辿ると、多くの場合はAIが参照した特定のURLにたどり着きます。古いプレスリリース、更新されていない比較サイトの記事、あるいはウィキペディア(日本語版)の不正確な記述がAI回答に入り込むケースが典型的です。引用元URLを特定できるツールであれば、「どのページを修正すれば波及効果が最も大きいか」を判断できます。
修正後のワークフローも重要です。コンテンツを更新しただけではAI回答が変化するまでに一定のタイムラグが生じます。修正後に同一プロンプトを再計測し、AI回答がどう変化したかを確認するまでをひとつのサイクルとして組み込むことで、施策の効果検証が可能になります。この「修正→再計測→確認」のサイクルを自動化できるかどうかが、運用コストの分岐点です。
誤情報が複数のAIエンジンで同時に発生している場合は、特定の引用元ページが複数エンジンに共通して参照されている可能性が高くあります。その場合は自社サイトの該当ページ、日本語版Wikipedia、主要な業界メディアの掲載記事を優先的に修正することが、最も広い修正波及効果を生みます。単一ページを直しても一部のエンジンにしか反映されないケースがある一方で、権威性の高いドメインの修正は複数エンジンに同時に波及することが多いのです。
日本語・英語横断比較:グローバル企業が多言語トラッキングで得られる示唆
日本語と英語のAI回答を同一ツールで並べると、市場ごとのブランドポジショニングのギャップが定量的に見えてきます。英語圏のChatGPT回答では第1位に推薦されているグローバルブランドが、日本語の同一プロンプトでは3位以降にも登場しないケースは珍しくありません。このギャップを可視化することではじめて、日本市場向けコンテンツ投資の優先度を議論できるようになります。
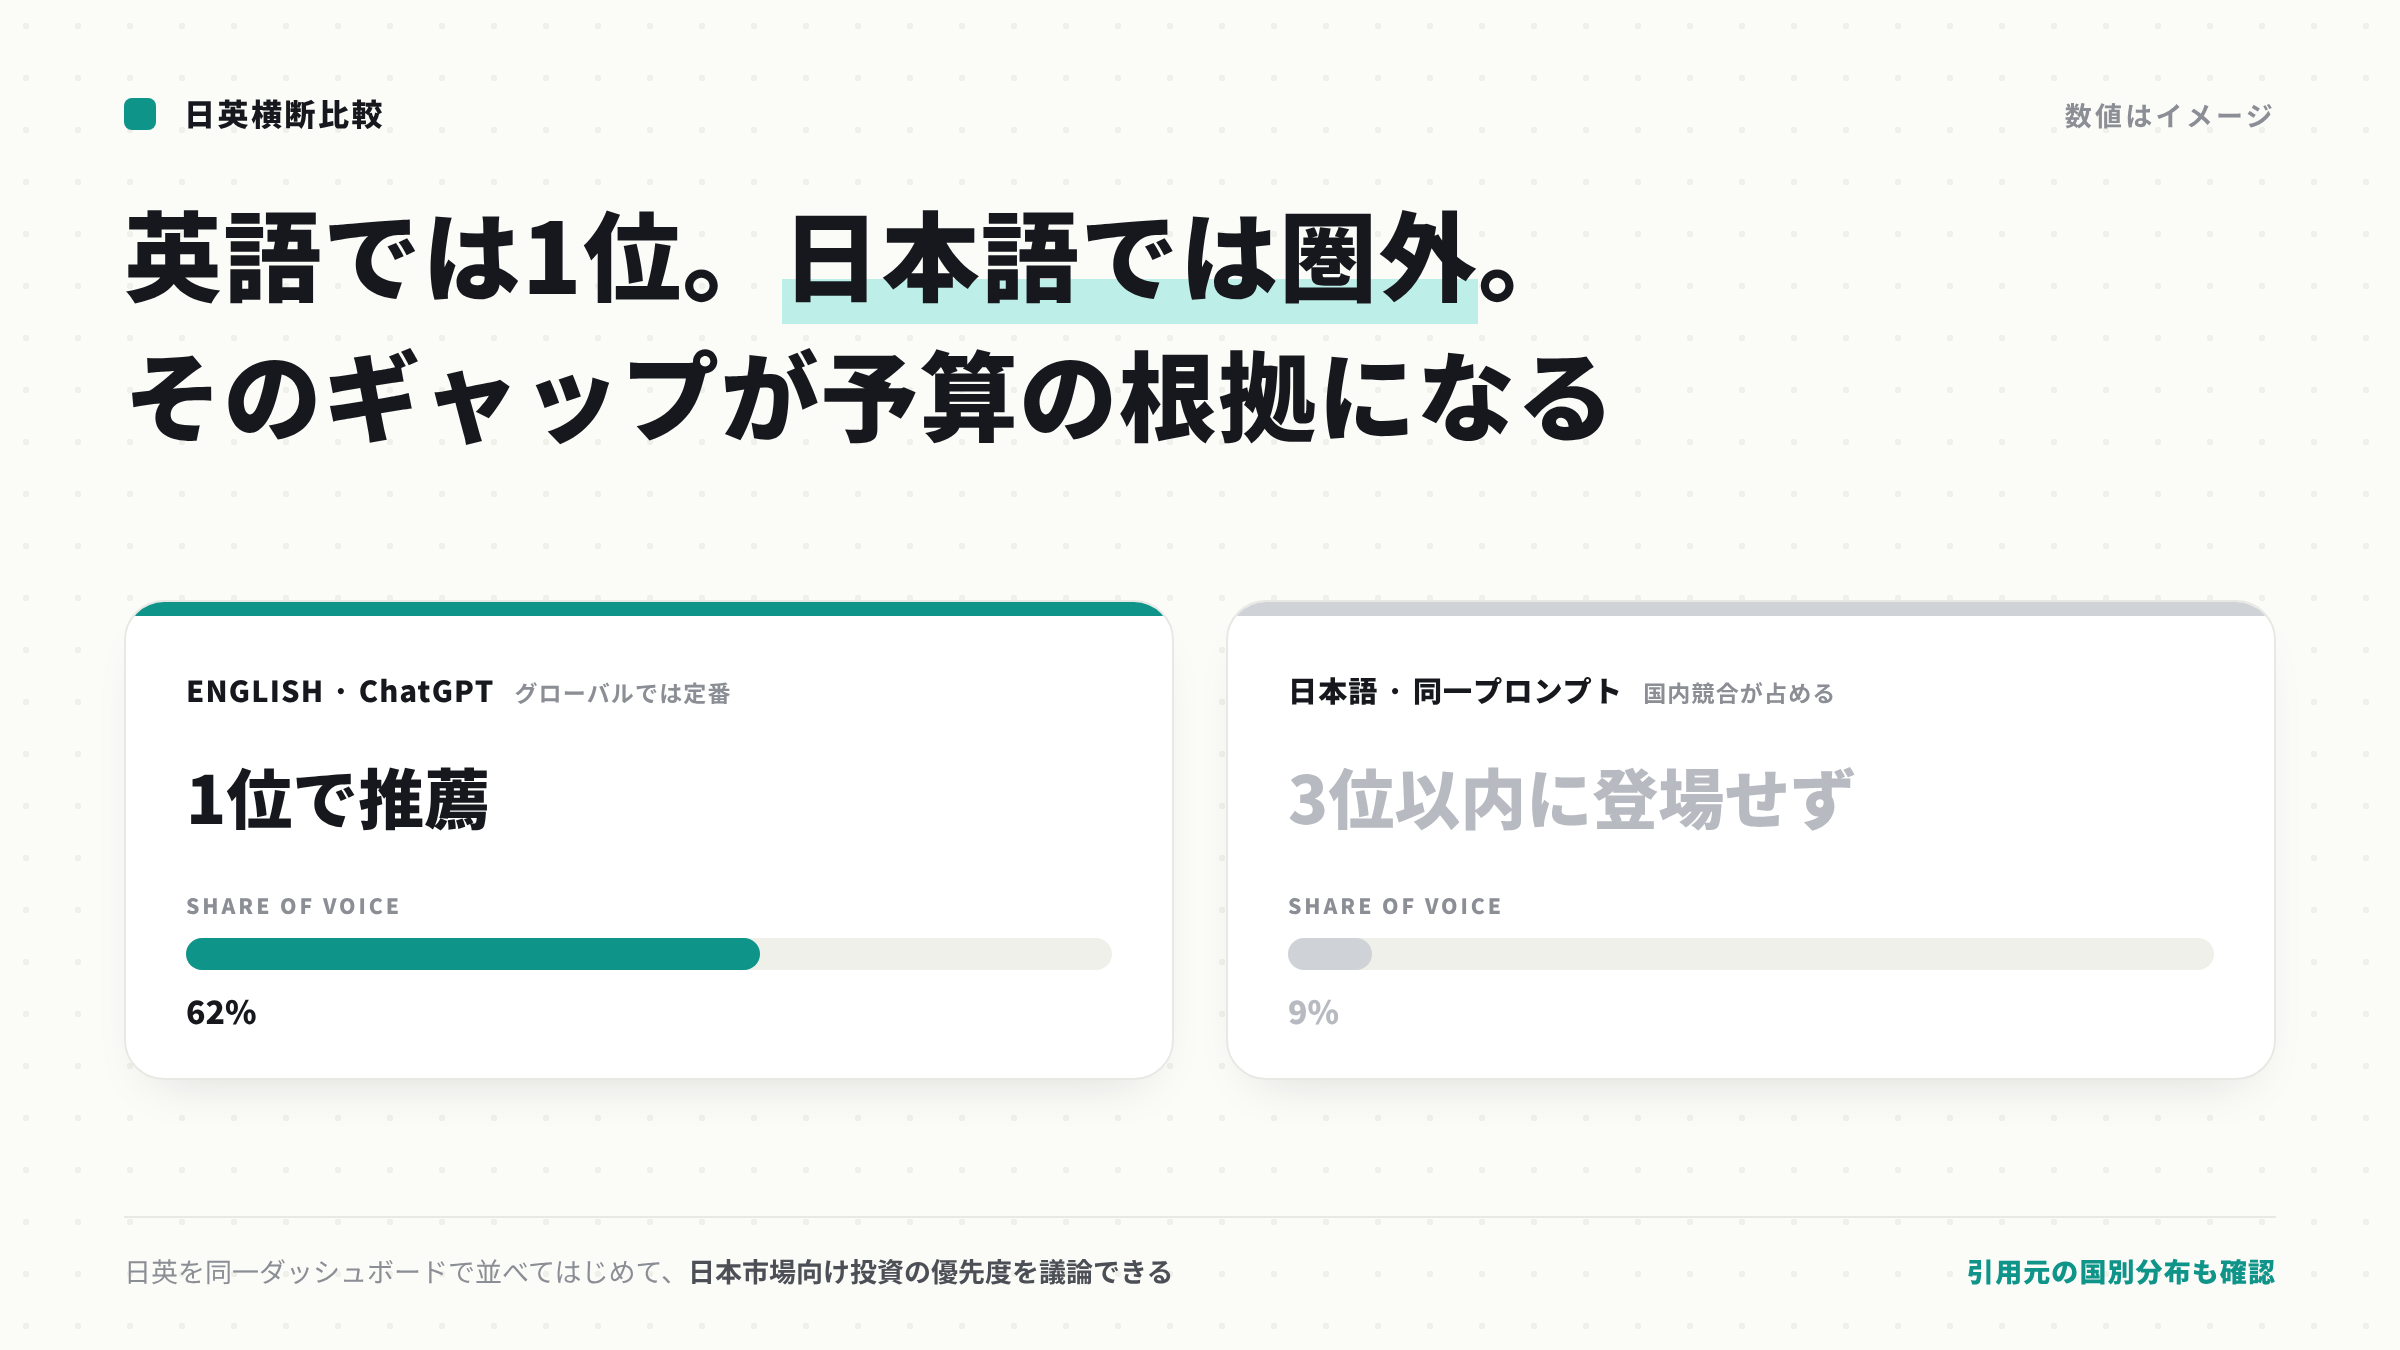
注目すべき指標のひとつは「Share of Voice(AI回答内での言及比率)」の日英比較です。英語では自社のShare of Voiceが高くても、日本語では競合他社が大半を占めているという状況が定量的に把握できれば、ローカルチームが本社に対して予算を要求する根拠として使えます。もうひとつは「引用されている上位ドメインの国別分布」で、日本語の回答で引用されているのが国内メディアか、それとも英語の海外サイトを日本語機械翻訳したコンテンツかによって、打つべき施策が変わります。
組織的なメリットも見逃せません。本社と日本のローカルチームが別々のツールを使ってAI検索状況を報告していると、定義やデータの取り方の違いから議論が噛み合わないことがあります。単一ダッシュボードで多市場・多言語のデータを管理できれば、会議の前提となるデータを統一できるのです。
プロジェクト分離型の構造を持つツールが、グローバル企業の運用に適している理由はここにあります。日本市場のプロンプト・競合設定・引用元分析を他市場のデータと混在させず、独立して管理できることが、長期的な運用の整合性を保つ条件になります。
国内競合にAI推薦で負けている原因を特定する方法
AI検索で国内競合ばかりが推薦される状況には、ほぼ必ず引用元コンテンツの格差があります。競合ブランドが掲載されているITmedia、価格.com、Qiita、あるいは業界特化の比較メディアといった日本語コンテンツが、AIに頻繁に参照されているのに対し、自社についての日本語コンテンツがそれらのサイトに存在しない、または情報が古いというパターンが典型的です。
LLMOツールの競合インテリジェンス機能を使うと、この状況を具体的な数値で把握できます。どの競合ブランドがどのプロンプトに対して何番目に推薦されているか、さらにその競合ブランドがどのURLから引用されているかを一覧で確認できるのです。「競合は引用されているが自社は引用されていないドメイン」のリストを取得できれば、そこへの掲載やコンテンツ配置を優先するという施策の方向性が明確になります。感覚ではなく、AIが実際に参照しているデータに基づいた逆算アプローチです。
Citadexのプラットフォームでは、AI回答内に登場した競合の引用元URLと、自社が引用されていないドメインをそれぞれ特定する機能を提供しており(citadex.io/about)、こうした分析を手動集計なしに実行できます。
競合の引用元分析を日英両言語で実施すると、さらに有益な示唆が得られます。英語市場では自社が掲載されているサイトカテゴリが、日本語市場では存在しない、あるいは別の形態のメディアが主流であるというパターンが浮き彫りになります。グローバルブランドが日本市場で欠いている日本語コンテンツ資産の種類を体系的に把握できれば、コンテンツ制作の優先順位をデータに基づいて決定できるのです。
よくある質問:日本語AI検索の計測・追跡ツールについて
Q: AEOとGEOの違いは何か?
A: AEO(Answer Engine Optimization)はChatGPTやPerplexityのようにAIが直接回答するエンジンへの最適化を指し、GEO(Generative Engine Optimization)は生成AI全般の回答に自社コンテンツを採用させる戦略を指します。概念的には若干ニュアンスが異なりますが、実務上は同義に使われることが多く、日本では「LLMO」という呼称が検索クエリとしては定着しつつあります。
Q: 日本語ブランドの計測に英語向けツールは使えるか?
A: 日本語プロンプトの個別設定と市場分離機能を持つツールであれば対応できる場合が多いです。ただし「多言語対応」と表記されていても、Google AI Overviewsの日本語版をカバーしているか、日本語の引用元URLを正確に記録できるかは事前に確認が必要です。試用期間中に実際の日本語プロンプトを投入してテストするのが最も確実な方法です。
Q: AEO施策の効果が出るまでどのくらいかかるか?
A: 引用元コンテンツの修正や追加を行ってからAI回答が変化するまで、数週間から数カ月のタイムラグが生じることが多くあります。エンジンによってもインデックス更新の頻度が異なるため、少なくとも1四半期は経過を観察したうえで効果を評価することを勧めます。施策の手応えをより早く把握したい場合は、変更後に同一プロンプトを再計測して変化を記録していくことが重要です。
Q: ChatGPTでの自社言及を無料で確認する方法はあるか?
A: ChatGPTに直接プロンプトを入力すれば、その時点での個別回答は手動で確認できます。ただし複数エンジン横断・時系列での変化追跡・競合との比較を無料かつ自動で網羅できるツールは、現時点では存在しません。手動確認では再現性もなく、回答のばらつきを平均化できないため、定量的な計測にはなりません。
Q: LLMOツールはSemrushやAhrefsといった既存SEOツールと何が違うか?
A: 既存のSEOツールは検索エンジンの順位・キーワードトラフィック・被リンクを計測対象とするのに対し、LLMOツールはAIが生成した回答文中でのブランド言及・推薦・引用元URLを計測対象とします。計測対象が根本的に異なり、GoogleのSERP順位が高くてもChatGPTの回答に登場しないケースは実際に多くあります。両方のKPIをカバーするには、SEOツールとLLMOツールを併用する体制が現実的です。
Q: どのAIエンジンを優先して追跡すべきか?
A: 自社の顧客層が実際に使用しているAIツールから逆算するのが基本です。日本市場ではChatGPT、Google Gemini、Perplexity、Google AI Overviewsの4つが2026年時点での優先候補です。業界や製品カテゴリによっては特定のエンジンでの検索頻度が突出することもあるため、可能であればユーザーインタビューやアクセスログ分析を組み合わせて優先度を設定することを推奨します。