GoogleはAEOとSEOを同じだと言うが、LLMOツールは本当に不要になったのか
要点:
- GoogleのAI OverviewsはSEOの仕組みの上に成り立つが、ChatGPTやPerplexityは独自の取得・引用ロジックで動いており、Googleの発言がそのまま当てはまるわけではない。
- llms.txtやチャンク分けは万能の最適化ファイルではなく、読みやすさと引用されやすさを高める編集上の工夫として捉えるべきもの。
- 自社ブランドが各AIエンジンでどう扱われているかは、単発の手動チェックではなく継続的な観測でしか正確には把握できない。
LLMO(AEO/GEO、AI回答エンジン最適化)とは、検索結果の順位ではなく、ChatGPTやPerplexity、Google AI Overviewsといった生成AIの回答の中でブランドがどう言及・引用されるかを管理する取り組みを指す。Googleが「AI OverviewsはSEOの延長で特別な対策は不要」という趣旨の説明をしてきたことから、「GEOツールはもう要らないのでは」という疑問が広がっている。この発言が指しているのはGoogle自身のAI Overviewsの話であり、ChatGPTやPerplexityの挙動とは別である。両者を混同すると、せっかくの観測や施策の判断を誤る。この記事では、Googleの発言の射程、llms.txtやチャンク分けの実際の効果、そして自社ブランドの露出を測る具体的な方法を整理する。
GoogleがいうSEOと同じという話は何を指しているのか
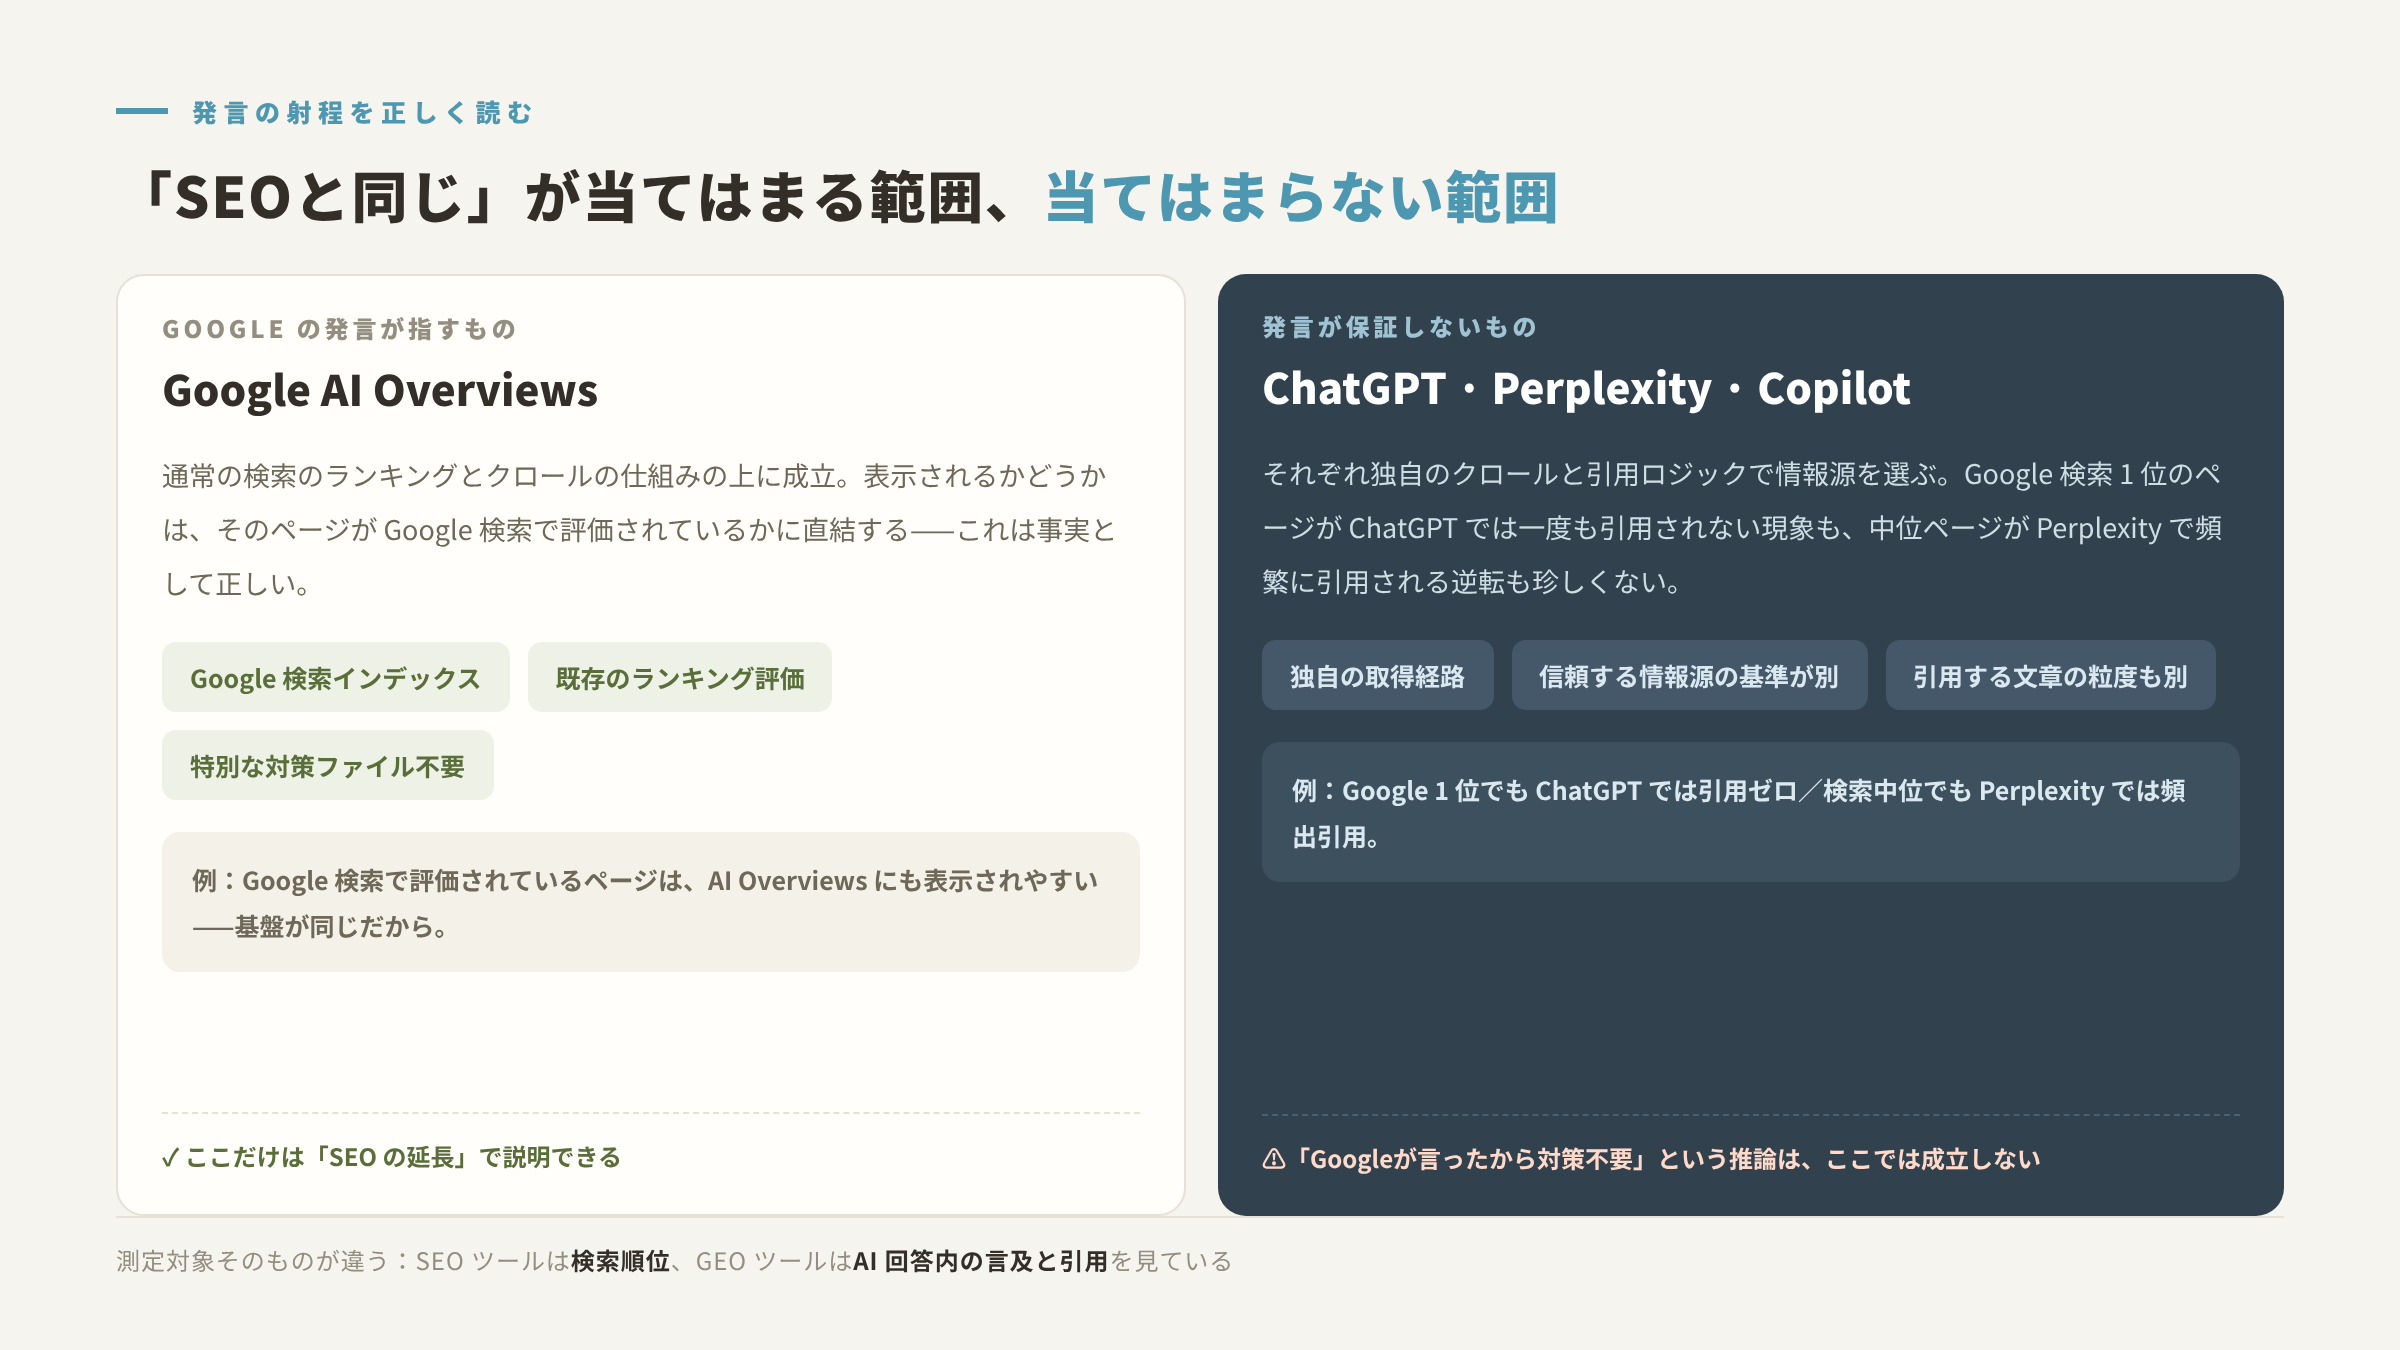
Googleの立場は「AI Overviewsは通常の検索のランキングやクロールの仕組みの上に成り立っている」というものだ。つまりAI Overviewsに表示されるかどうかは、基本的にそのページがGoogle検索で評価されているかどうかと直結している。これは事実として正しいが、あくまでAI Overviewsという一つの機能についての説明であることを見落としてはいけない。
よくある誤読は「AI周りは全部SEOと同じ」という風に話を広げてしまうことだ。AI Overviewsの裏側がGoogle検索のインデックスを使っているのは確かだとしても、ChatGPTやPerplexityは、Googleの検索インデックスとは別の取得経路や引用ロジックを持っている。発言の射程を「Google AI Overviews」に限定して読むのが正確な理解だ。
ChatGPTやPerplexityはGoogle検索と同じ仕組みで動いているのか
同じではない。SEOツールが見ているのは検索結果でのページの順位であるのに対し、GEO系のツールが見ているのはAIの回答の中での言及や引用そのものだ。GEO対策ツールの比較記事でもこう整理されている。測定対象そのものが違うのだから、最適化の勘所も当然変わってくる。
ChatGPTの検索機能やPerplexity、Copilotは、それぞれ独自のクロールとランキングのロジックで情報源を選び、回答に組み込んで引用する。Google検索で1位を取れているページが、ChatGPTの回答では一度も引用されない現象は珍しくない。逆に、Google検索では中位にあるページがPerplexityでは頻繁に引用元として挙がることもある。これはエンジンごとに「何を信頼できる情報源とみなすか」「どの粒度の文章を抜き出して引用するか」の基準が異なるためだ。
「GoogleがSEOと同じと言っているから、ChatGPTやPerplexity向けの施策も不要」という推論は成立しない。Googleの発言は自社のAI Overviewsについての説明であり、他社のAIエンジンの挙動を保証するものではないからだ。
GEOツール(LLMO)はまだ必要なのか:判断のための3つの基準
「要るか要らないか」を感覚で決めるのではなく、次の3つの基準で自分の状況を点検するとよい。
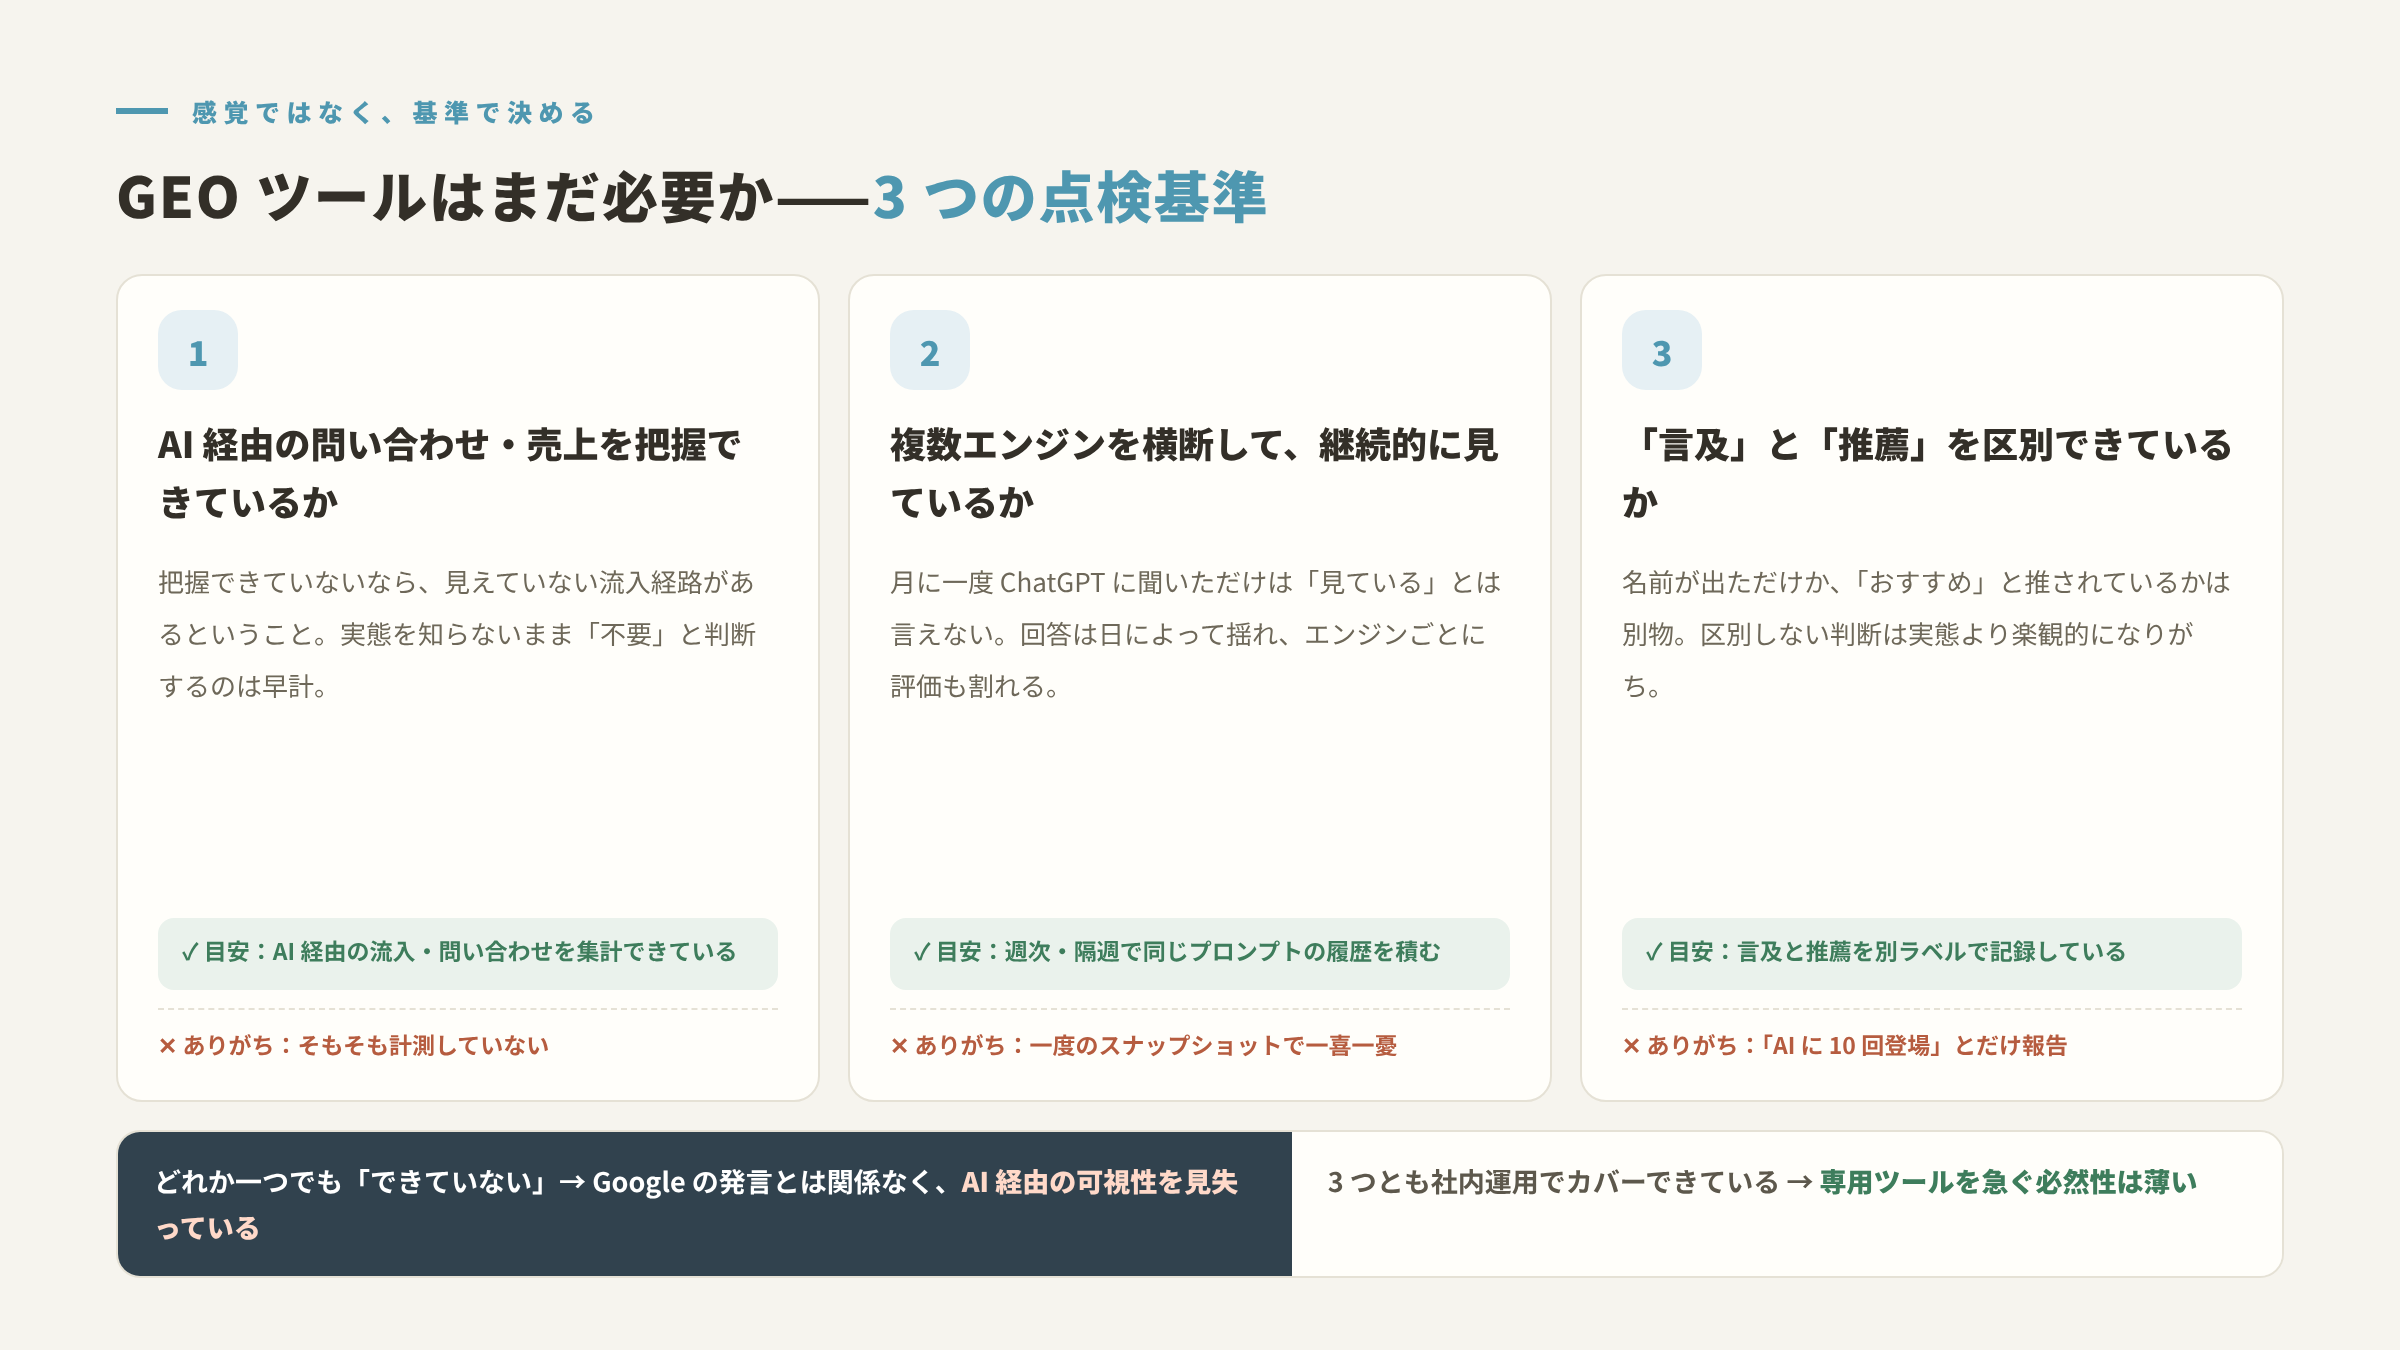
基準1:自社への問い合わせや売上のうち、AI経由のものを把握できているか。 もし把握できていないなら、見えていない流入経路があるということだ。AIからの流入が実際にどれだけあるかを知らないまま「不要」と判断するのは早計である。
基準2:複数のAIエンジンを横断して、継続的に見ているか。 月に一度ChatGPTに質問してみただけという状態は「見ている」とは言えない。AIの回答は同じ質問でも日によって変わりうるし、エンジンごとに評価が割れることも多い。一度のスナップショットと、週単位・隔週単位で積み上げた履歴では見えてくるものが全く違う。
基準3:「言及」と「推薦」を区別できているか。 AIがブランド名を出しただけなのか、それとも実際に「おすすめです」と推している文脈なのかは意味が全く異なる。前者は競合と並べて中立的に紹介されているだけかもしれず、後者は購買意思決定に直接影響する。この区別ができていない状態での判断は、実態より楽観的になりがちだ。
この3つのどれか一つでも「できていない」なら、今の自社の体制はGoogleの発言とは関係なく、AI経由の可視性を見失っている。逆に3つとも社内の運用だけで十分にカバーできているなら、専用ツールを急いで導入する必然性は薄い。
llms.txtやコンテンツのチャンク分けはGoogleのAI Overviewsに効果があるのか
llms.txt単体を置いただけで、AI Overviewsでの扱いが劇的に変わることは期待しにくい。これは「特別な対策ファイルがなくても機能する」というGoogleの基本方針とも整合する。llms.txtはあくまでAIクローラーに向けた案内の一種であり、検索エンジンのランキング評価そのものを書き換える仕組みではない。
見落とされがちなのが、「チャンク分け」には二つの意味があるという点だ。一つは、AIに読ませるための自動生成ファイル(llms.txtのようなもの)としてコンテンツを機械的に分割すること。もう一つは、見出し・箇条書き・FAQブロックといった形で、人間にもAIの抽出ロジックにも読みやすい単位に文章を整理する編集上の工夫としてのチャンク分けだ。後者は多くのAIエンジンが回答を組み立てる際に、ページ全体ではなく文章の一部分(パッセージ)を抜き出して引用する挙動と相性がよい。見出しごとに一つの問いに一つの答えを置き、結論を先に書く構成にしておくと、どのAIエンジンにとっても抜き出しやすい単位になる。
実務的には、llms.txtの有無を気にするより先に、既存ページを「一つの見出し=一つの明確な主張」という単位に整理し直す方が投資対効果は高い。Citadexの「答案資産」機能は、AIにまだ推奨されていない質問に対して比較記事やQ&A形式のコンテンツ案を生成し、公開後に該当プロンプトを再検査して効果を確認できるようにしている。これは「ファイルを置く」のではなく「引用されやすい文章構造を作る」というアプローチの一例と言える。
ChatGPTやPerplexityが自社ブランドを推薦しているかはどう測ればいいのか
測定は次の手順で組むと再現性が出る。
- プロンプトのリストを作る。 「〇〇 おすすめ」「〇〇 vs 競合」「〇〇 口コミ」のように、実際の見込み客が打ちそうな質問を書き出す。検索キーワードではなく、会話的な質問文であることが重要だ。
- 複数のAIエンジンで同じプロンプトを聞く。 ChatGPT、Perplexity、Geminiなど、ターゲット層が実際に使っていそうなエンジンを選ぶ。一つのエンジンだけで判断すると偏りが出る。
- 「言及」と「推薦」を分けて記録する。 名前が出ただけなのか、積極的に薦められているのかをタグ付けする。
- 引用元のURLを記録する。 自社サイトのどのページが引用されたか、競合のどのページが引用されて自社は引用されなかったかを見る。
- 一定のリズムで繰り返す。 週次か隔週で同じプロンプトを再検査し、変化を履歴として残す。
この手順を手動でやろうとすると、プロンプト数が増えるほど現実的ではなくなる。Citadexはこの一連の流れを自動化していて、各プロンプトについて各AIエンジンでの回答、言及の有無、ランキング、感情傾向、引用元を記録し、回答の原文も保存した上で時系列の変化を追えるようにしている。さらに「言及」と「推薦」を区別するタグがあり、AIがどの競合を引用元として使っているかも併せて把握できる。無料の検査機能では、URLを入力するだけでChatGPT・Gemini・Perplexityの実際の回答を任意の国と言語で確認でき、中国市場向けにDeepSeekや豆包、通義千問に切り替えて見ることもできる。まずはこの無料検査で自社の現在地を確認してから、継続的な観測が必要かどうかを判断するのが手堅いやり方だ。
具体例:20個のプロンプトで自社ブランドの見え方を追ってみる
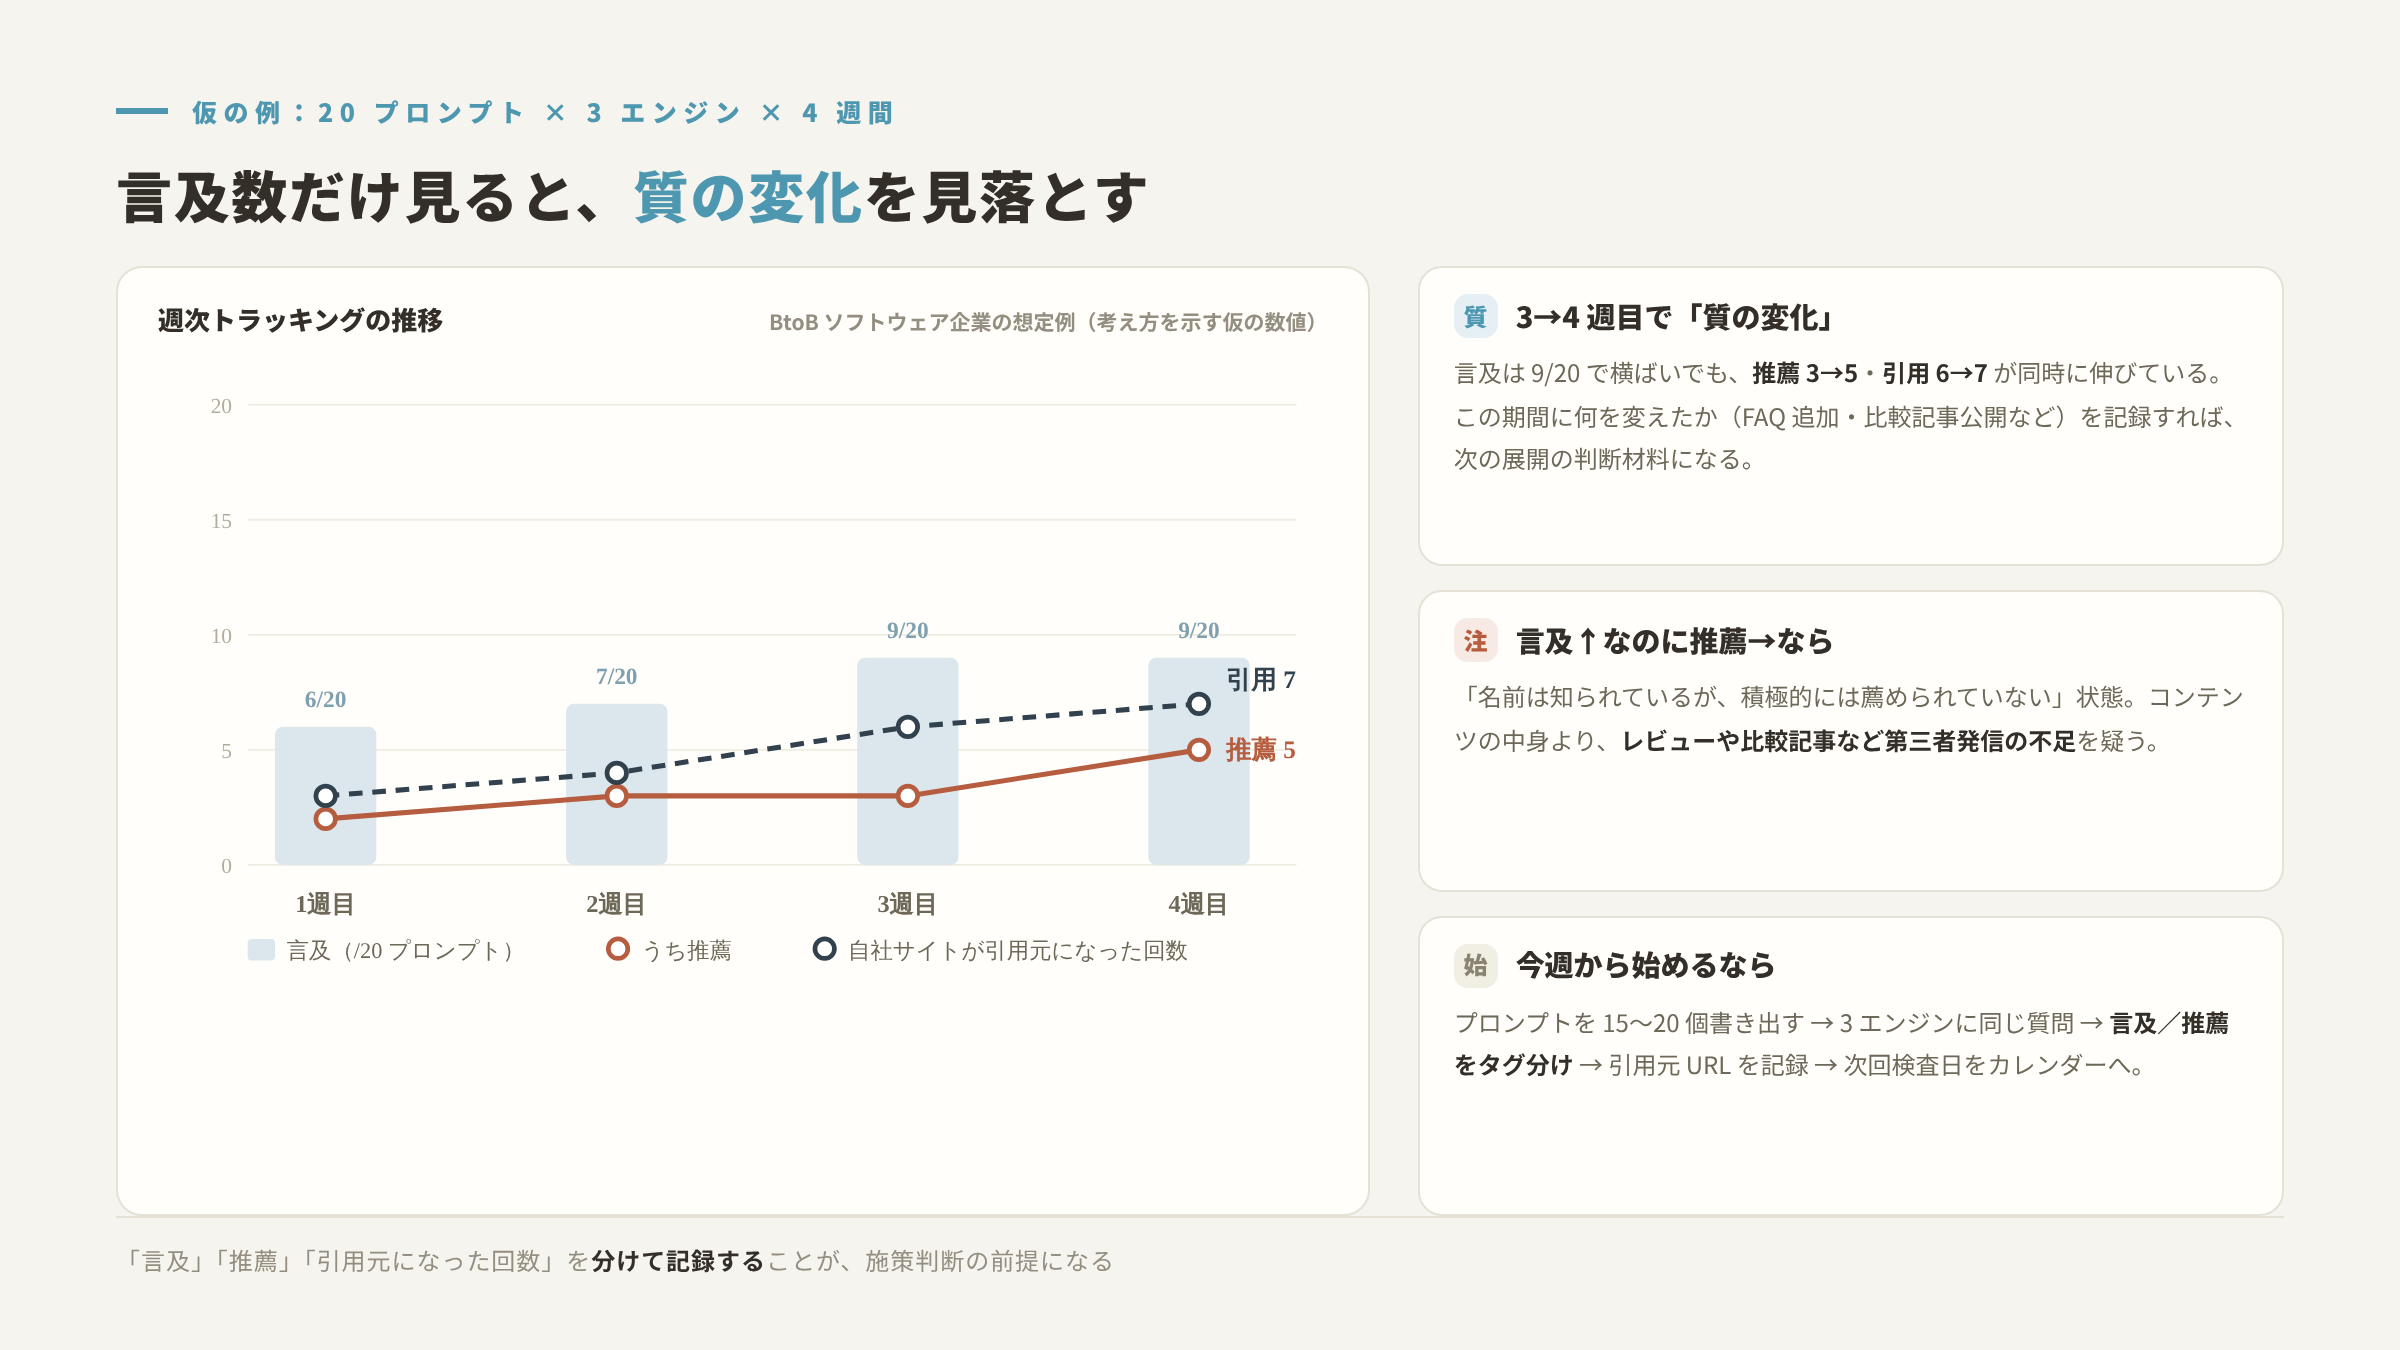
数字で考えると判断がしやすくなる。仮にBtoBソフトウェアの会社が、カテゴリ名と自社名を絡めたプロンプトを20個用意し、ChatGPT・Perplexity・Geminiの3エンジンで4週間追跡したとする。これはあくまで考え方を示すための仮の例だ。
| 週 | 言及されたプロンプト数 | うち推薦と判定された数 | 自社サイトが引用元になった回数 |
|---|---|---|---|
| 1週目 | 6/20 | 2 | 3 |
| 2週目 | 7/20 | 3 | 4 |
| 3週目 | 9/20 | 3 | 6 |
| 4週目 | 9/20 | 5 | 7 |
このケースで重要なのは「推薦」と判定された数と「自社サイトが引用元になった回数」が同時に伸びている点だ。言及数だけを見ていると変化が小さく見えるが、推薦数と引用回数を分けて見ると、3週目から4週目にかけて質の変化が起きていることがわかる。この期間に何を変えたか(ページ構成の見直し、FAQの追加、比較記事の公開など)を記録しておくと、次に同じ施策を他のページにも展開する判断材料になる。
逆に言及数は増えているのに推薦数が横ばいなら、AIに「名前は知られているが積極的には薦められていない」状態が続いていることになる。その場合は、コンテンツの中身というより、ユーザーのレビューや比較記事といった第三者発信の情報が不足している可能性を疑うべきだ。
よくある失敗パターン
Googleの発言を理由に全エンジンを放置する。 AI Overviews向けの説明を根拠に、ChatGPTやPerplexity経由の露出もまとめて「対策不要」と判断してしまうケース。発言の射程はGoogle自身の機能に限られる。
llms.txtを置けば終わりだと思い込む。 ファイルを設置した達成感で満足し、実際のコンテンツ構造(見出し単位の明確さ、FAQの有無)を見直さないまま放置してしまう。
一回の質問で判断する。 担当者が思いつきでChatGPTに一度質問してみて、「出てこなかったから自社は弱い」あるいは「出てきたから大丈夫」と結論づけてしまう。AIの回答は同じ質問でも揺れがあるため、一度の結果で一喜一憂するのは早計だ。
言及と推薦を混同したまま報告する。 社内レポートで「AIに10回登場した」とだけ書いて、そのうち何回が実際の推薦だったかを分けていない。意思決定者が実態より楽観的な印象を持ってしまう。
自社サイトだけ見て、引用元の分布を見ない。 AIが競合のどのページを引用しているかを見ずに、自社のコンテンツ改善だけを続けてしまうと、競合が埋めている情報の穴(比較表、口コミ、第三者レビューなど)に気づけない。
チェックリスト:今週やるべきこと
- 自社名とカテゴリ名を絡めたプロンプトを15〜20個書き出す。
- 無料の検査ツールか手動で、ChatGPT・Perplexity・Geminiそれぞれに同じプロンプトを投げてみる。
- 回答ごとに「言及のみ」か「推薦」かをメモする。
- 引用元URLを記録し、自社ページと競合ページの比率を見る。
- 既存の主要ページを見出し単位で読み直し、一つの見出しに一つの明確な答えが書かれているか確認する。
- 次回の検査日をカレンダーに入れて、同じプロンプトで定点観測を始める。
よくある質問
Q: Googleの発言はAI Overviews以外のGoogleの機能にも当てはまるのか?
A: ここで扱っているのはAI Overviewsについての説明であり、Google検索の通常のランキングやクロールの仕組みを土台にしているという点に限定した話だ。Google内の他の機能やGoogle以外のAIエンジンの挙動まで同じ論理で説明できるわけではない。話を広げて一般化しないほうがいい。
Q: 自社サイトにllms.txtを置くこと自体に害はあるのか?
A: 設置自体が有害になることは基本的にない。ただしそれで安心してコンテンツ構造の見直しを後回しにしてしまうと、本来やるべき「見出し単位で読みやすく書く」という作業が進まなくなる。ファイルは補助的なものとして捉え、本体のコンテンツ整理を優先する方がいい。
Q: 中小企業でもAIエンジンでの露出を継続的に観測する価値はあるか?
A: 競合との相対的な位置づけが知りたいかどうかで判断するとよい。問い合わせの経路が限られていて、AI経由の流入が無視できる規模なら急ぐ必要はない。逆に見込み客が購買前にAIに質問する業界であれば、小さな規模のプロンプトセットからでも定点観測を始める価値はある。
Q: 推薦されていると判定する基準は何を使えばいいのか?
A: 「単に名前が挙がっている」のか「他の選択肢と比べて積極的に薦められている」のかを、回答の文脈から人の目で判断するのが基本になる。自動化されたツールを使う場合も、言及と推薦を別のラベルとして記録している仕組みかどうかを確認しておくと、後からの分析がしやすくなる。
Q: AIに引用されやすいページを後から追加することに意味はあるか?
A: 意味はある。比較記事やFAQ形式のコンテンツ、具体的な数値や事例を含む解説記事は、AIエンジンが回答を組み立てる際に引用しやすい素材になりやすい。既存ページの改修と、まだカバーできていない質問に対する新規コンテンツの追加を両輪で進めるのが現実的なやり方だ。