要点:
- AIエンジンにおけるブランド言及は、モデルが学習したデータだけでなく、回答時に取得・引用するウェブ上のページに大きく左右される。
- 日本語の質問では、AIが裏で行う検索の言語と、引用されるサイトの顔ぶれが英語と異なる。計測も市場(国)と言語を日本に揃えて行う必要がある。
- 継続的な可視性監視には、単発の検索ではなく構造化された質問セットを定期的に実行し、言及率と文脈の両方を記録する仕組みが必要になる。
AIが日本のユーザーの質問に答えるとき、あなたのブランドは何回、どのような文脈で登場しているか。この問いに答えられる企業は、まだそれほど多くない。ChatGPTやPerplexityなどの主要AIエンジンは、ウェブから取得したコンテンツをもとに回答を生成・引用するため、SEOとは異なるロジックでブランドの見え方が決まる。日本語の質問では、AIが参照するサイトの顔ぶれも英語とは違うため、英語市場の追跡手法をそのまま流用しても実態はつかめない。本記事では、AIエンジンにおけるブランド言及追跡の仕組みと、日本語で追跡するときに押さえるべき点を解説する。
AIエンジンにおけるブランド可視性とは何か?
ブランド可視性の意味は、従来のSEOとAIエンジンで根本的に異なる。
検索エンジンがURLの順位を返すのに対し、ChatGPTやPerplexityは自然言語でまとめた回答を返す。その回答の中にブランド名が登場するか、出典として引用されるかが、AIエンジンにおけるブランド可視性の核心だ。そして回答の中身は、学習データだけでなく、回答を作るときに取得できるウェブ上のページの内容と、その中での自社の扱われ方に大きく左右される。
具体的に言えば、PerplexityがあるB2Bソフトウェアについての質問を受け取ったとき、レビューサイトや業界メディア、比較記事など複数のページを検索し、その場で取得した内容から回答を組み立てる。あなたのブランドが登場するかどうかは、それらのページで自社がどう紹介されているかで決まる。
追跡の目的も変わる。従来のSEO指標(順位・インプレッション数)ではなく、特定の質問における「言及率」「引用頻度」「文脈上の位置づけ(競合と比べてどう語られているか)」が主要な指標になる。
なぜ日本語クエリは英語とは別に追跡しなければならないのか?
日本語の質問の追跡は、英語の追跡手法をそのまま翻訳しても機能しない。
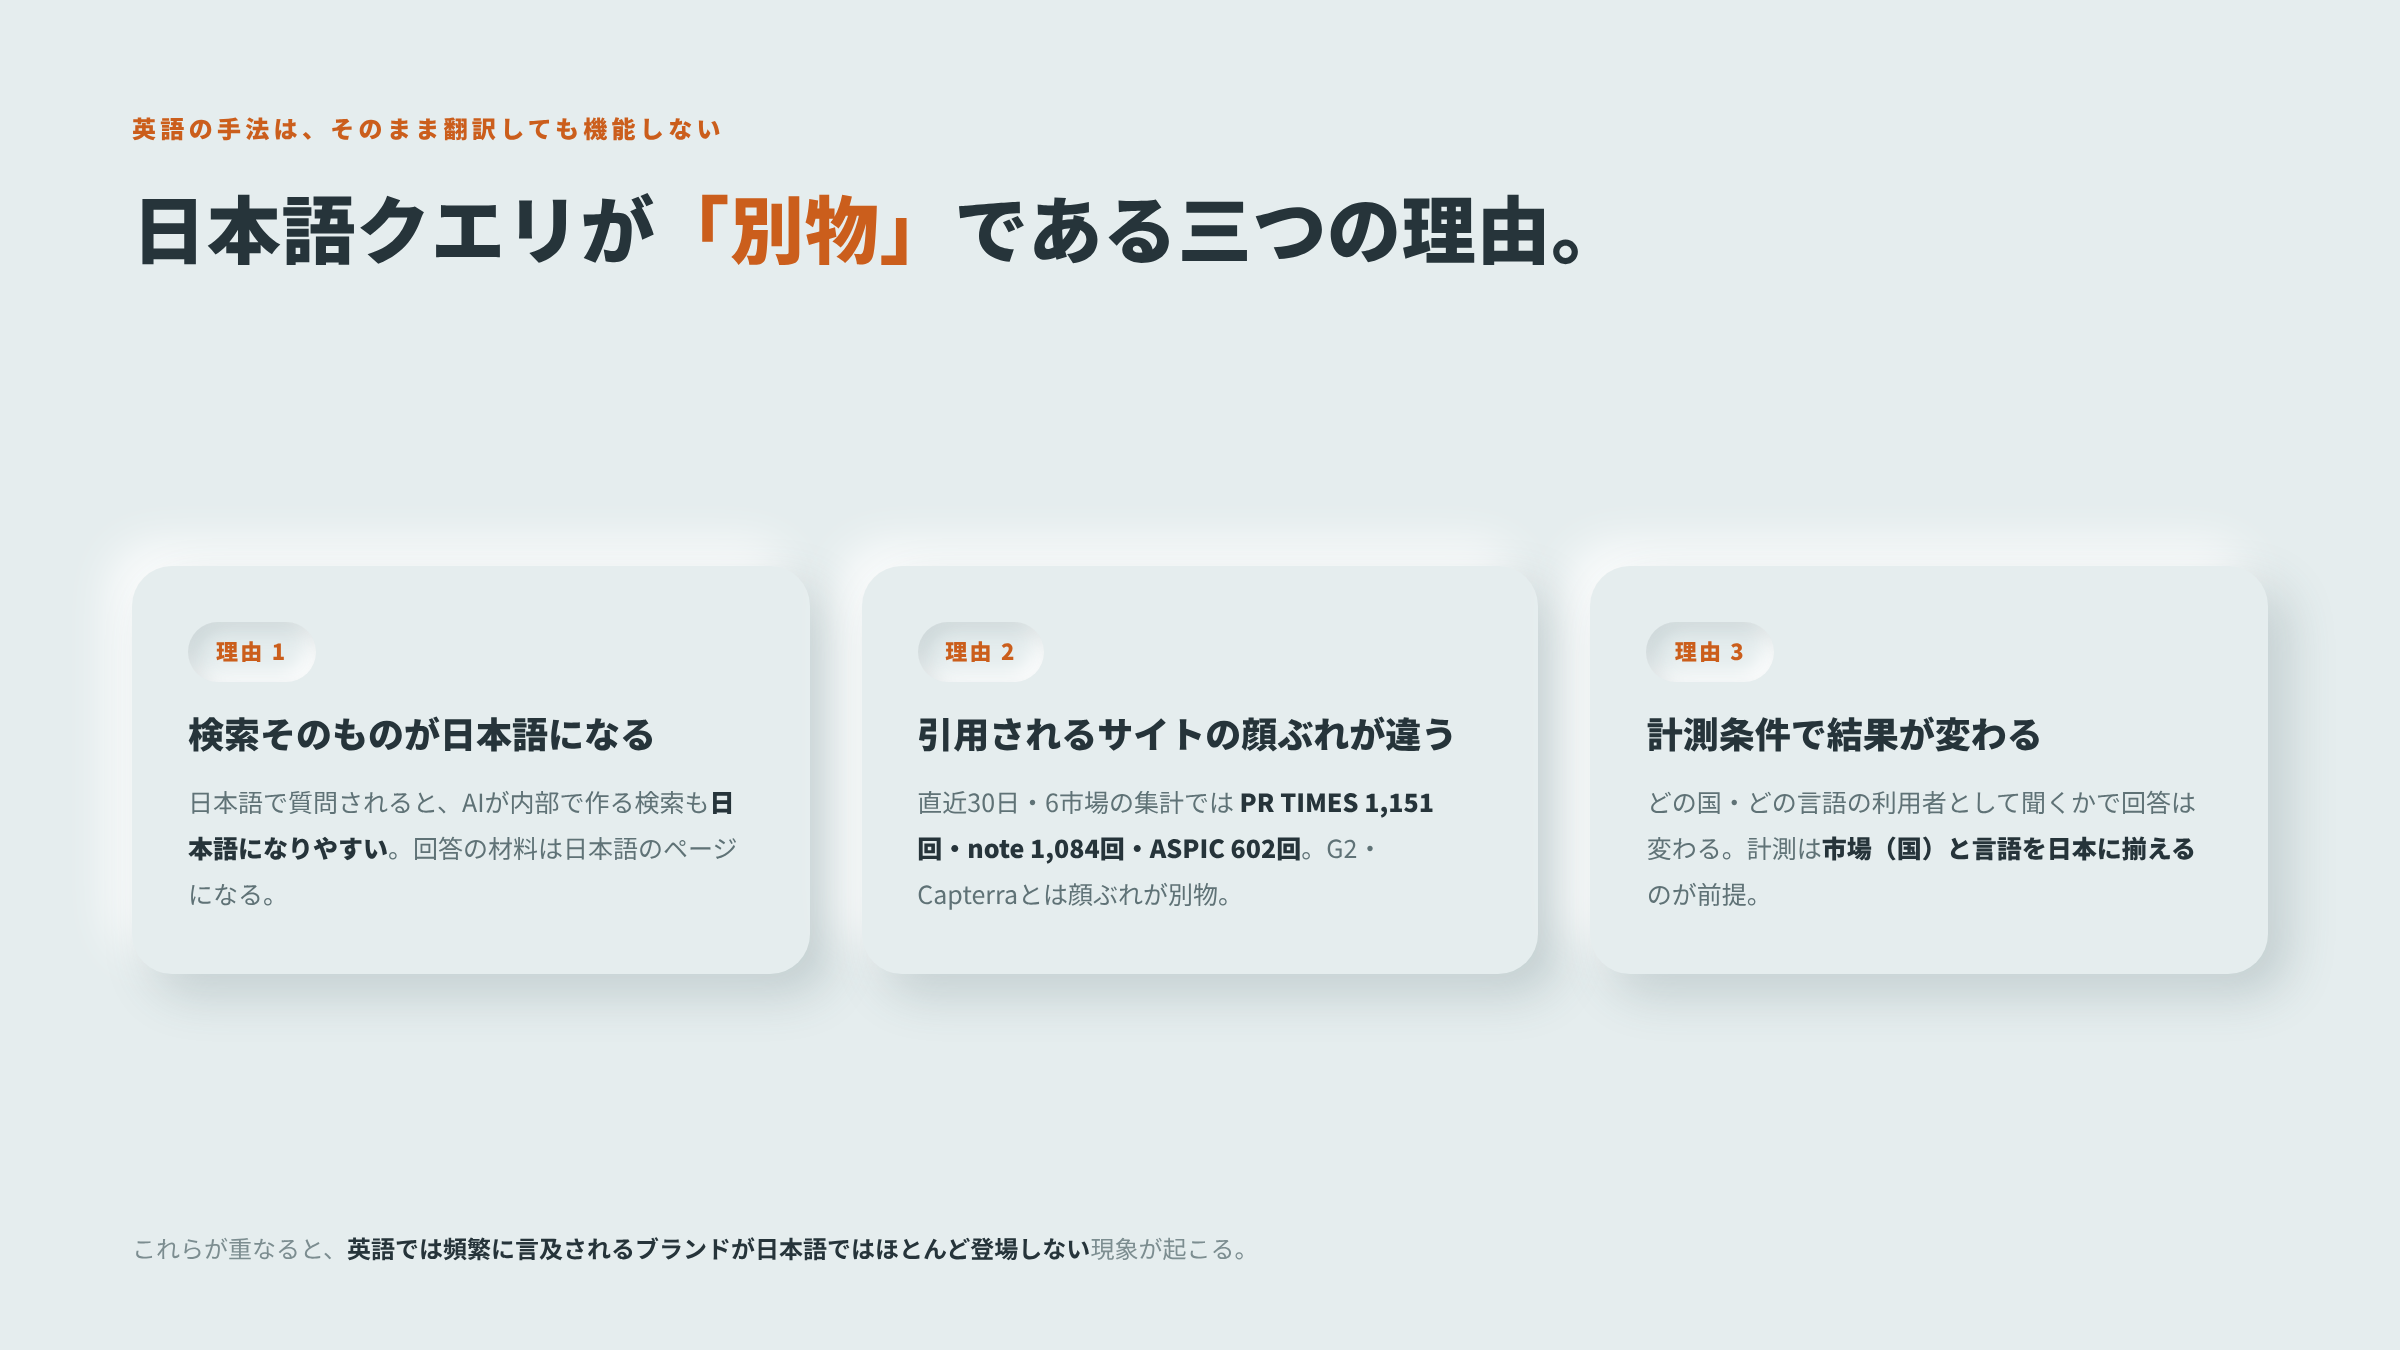
第一の理由は、AIが裏で行う検索そのものが変わることだ。ChatGPTやPerplexityは、質問を受けると回答の材料を探すための検索クエリを内部で作る。日本語で質問されれば検索も日本語で行われやすく、結果として日本語のページが回答の材料になる。同じブランドでも英語と日本語で引用頻度が大きく変わるのはこのためだ。
第二の理由は、引用されるサイトの顔ぶれの違いだ。Citadex が自社プロジェクト(日本を含む6市場、直近30日)で集計したところ、よく引用されていたのは PR TIMES(1,151回)、note(1,084回)、ASPIC(602回)や、各社が公開しているツール比較記事だった。英語市場で定番の G2 や Capterra とは顔ぶれが大きく異なる。英語のコンテンツしか持たないブランドは、日本語の質問では引用される機会そのものが少ない。
第三は計測条件の問題だ。AIの回答は、どの国・どの言語の利用者として質問したかで変わりうる。英語圏の条件で計測していては、日本のユーザーが実際に目にする回答とずれる可能性がある。計測するときは、市場(国)と言語を日本に揃えることが前提になる。
AIエンジンはどのようにして回答時にコンテンツを取得・引用するのか?
回答が作られる流れを理解することが、効果的な追跡設計の前提になる。
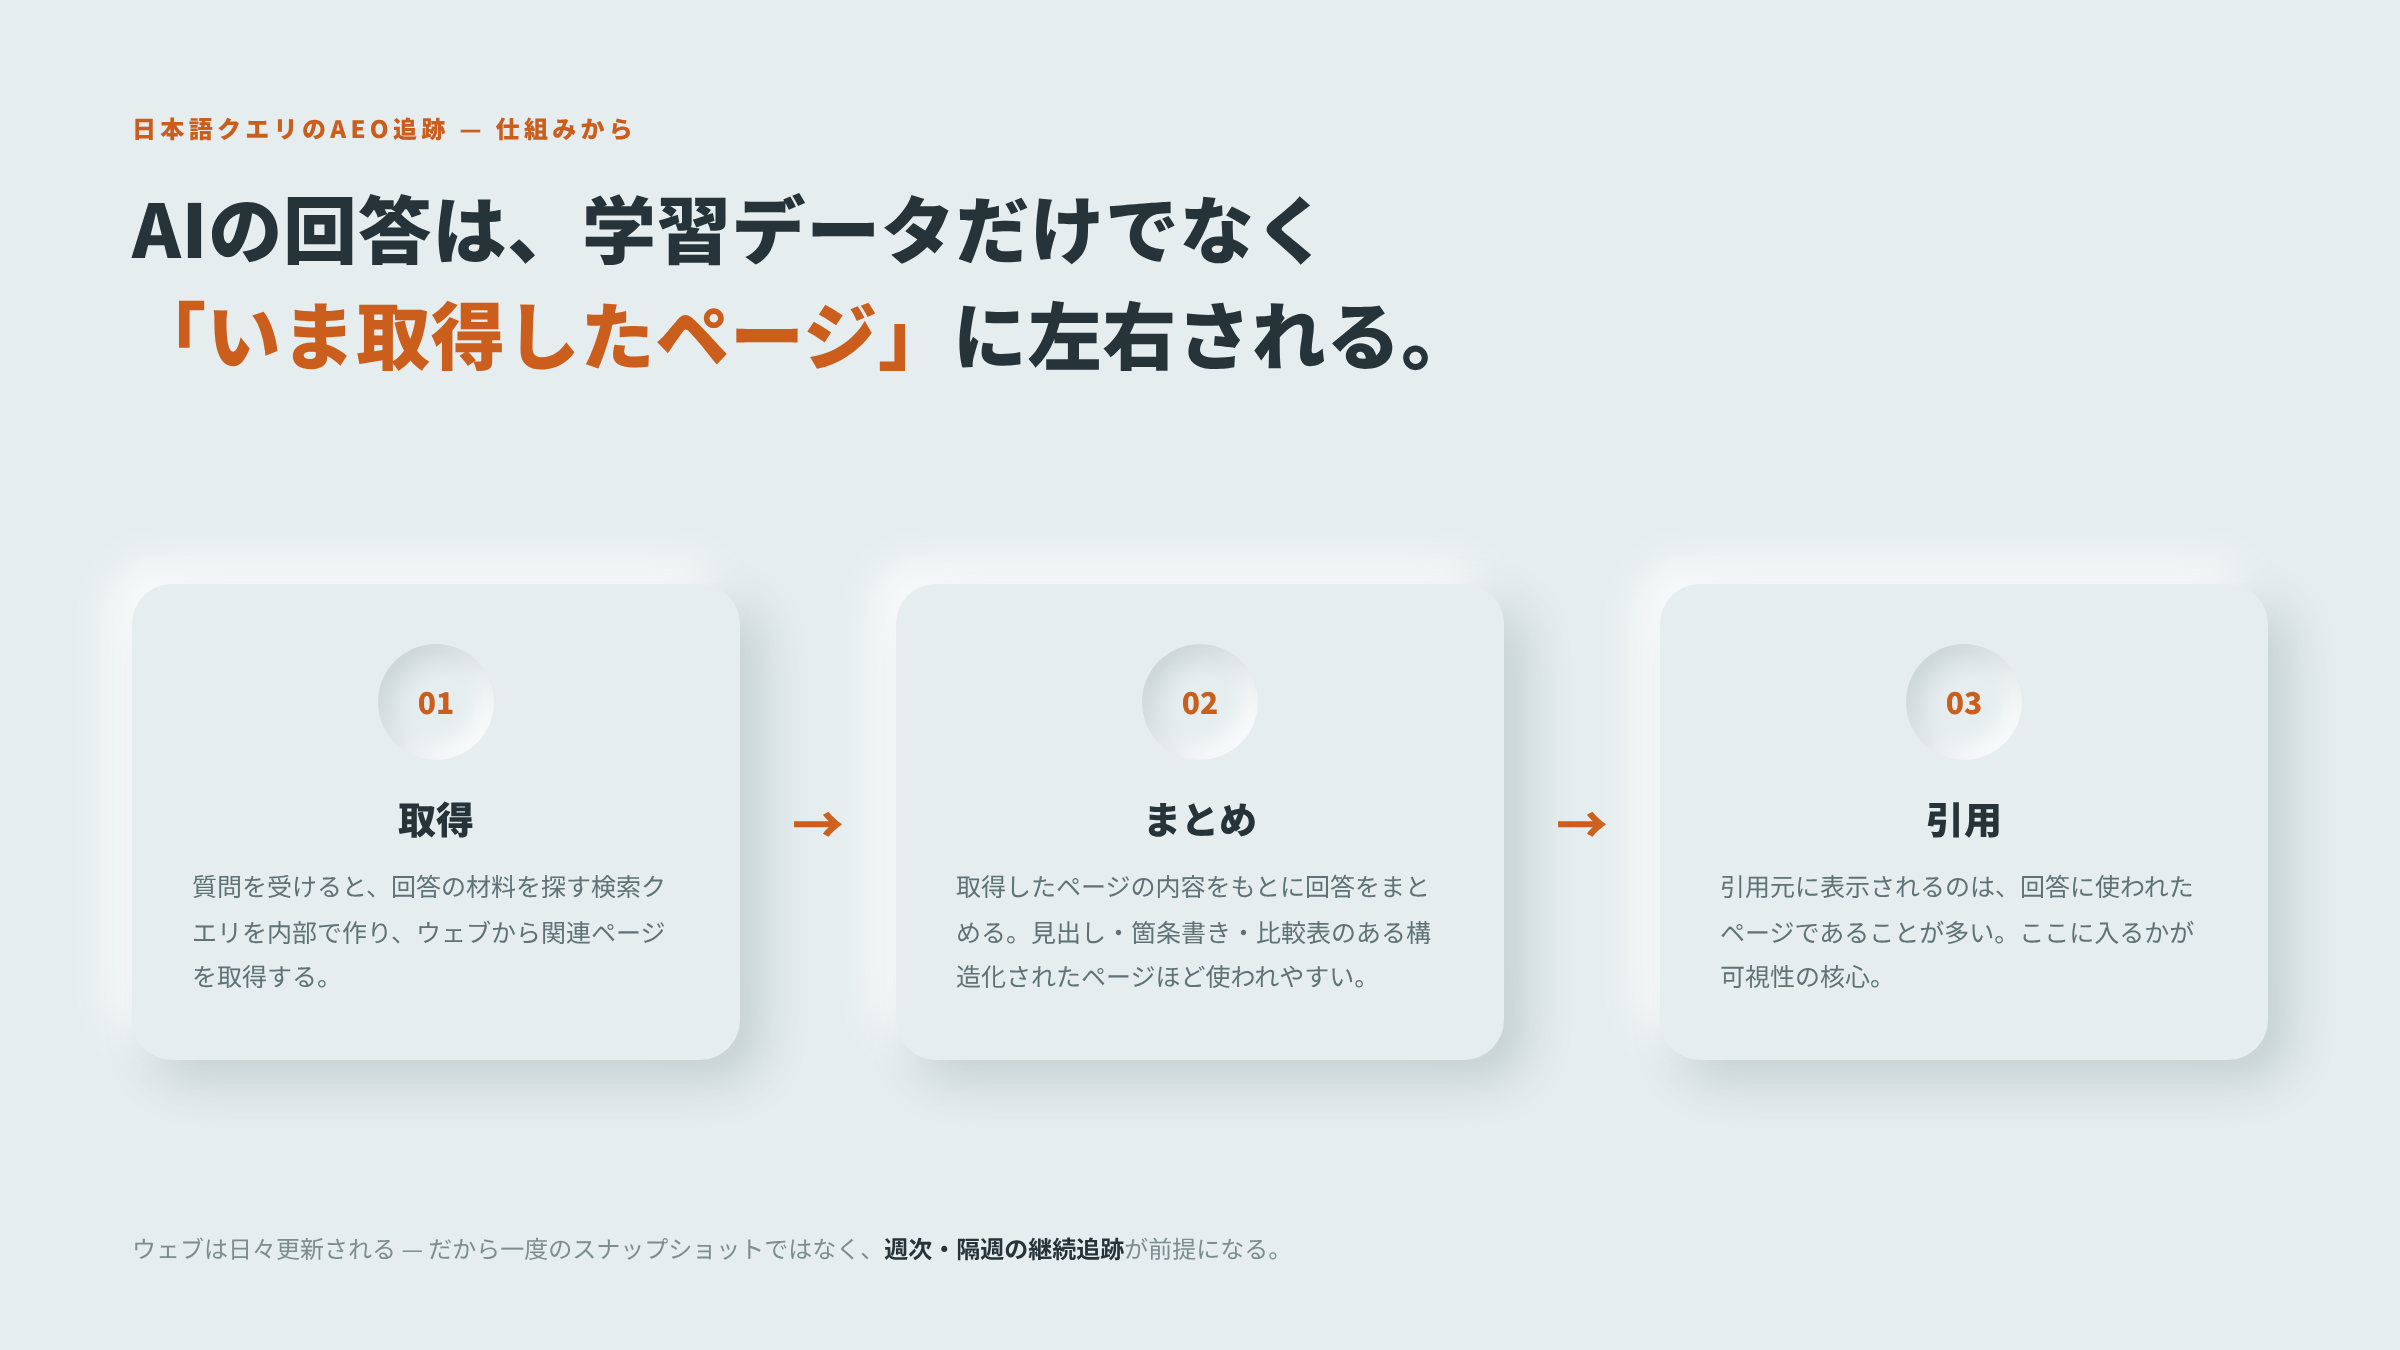
ChatGPT(ウェブ検索が使われる場合)やPerplexityは、質問を受け取ると内部で検索クエリを作り、ウェブから関連ページを取得する。取得したページの内容をもとに回答をまとめ、引用元が表示される場合は、回答に使われたページであることが多い。
この「取得 → まとめ → 引用」の流れで重要なのは、ページの構造だ。見出し・箇条書き・比較表を持つページは、AIが情報を整理しやすく、引用されやすい傾向がある。FAQページがAEO(Answer Engine Optimization)で重視される理由もここにある。
追跡という観点からは、「ある時点のスナップショット」では不十分だということになる。AIエンジンが取得するページは日々更新されるため、先月の結果が今月の実態を表しているとは限らない。週次や隔週の定期実行が必要なのはこのためだ。
ChatGPT・LLMO・AEO・GEOの基本概念についての詳細はこちらを参照されたい。
継続的追跡のためにどのような質問セットを設計すべきか?
追跡の精度は質問の質で決まる。単発の検索を繰り返すだけでは、比較できるデータは得られない。
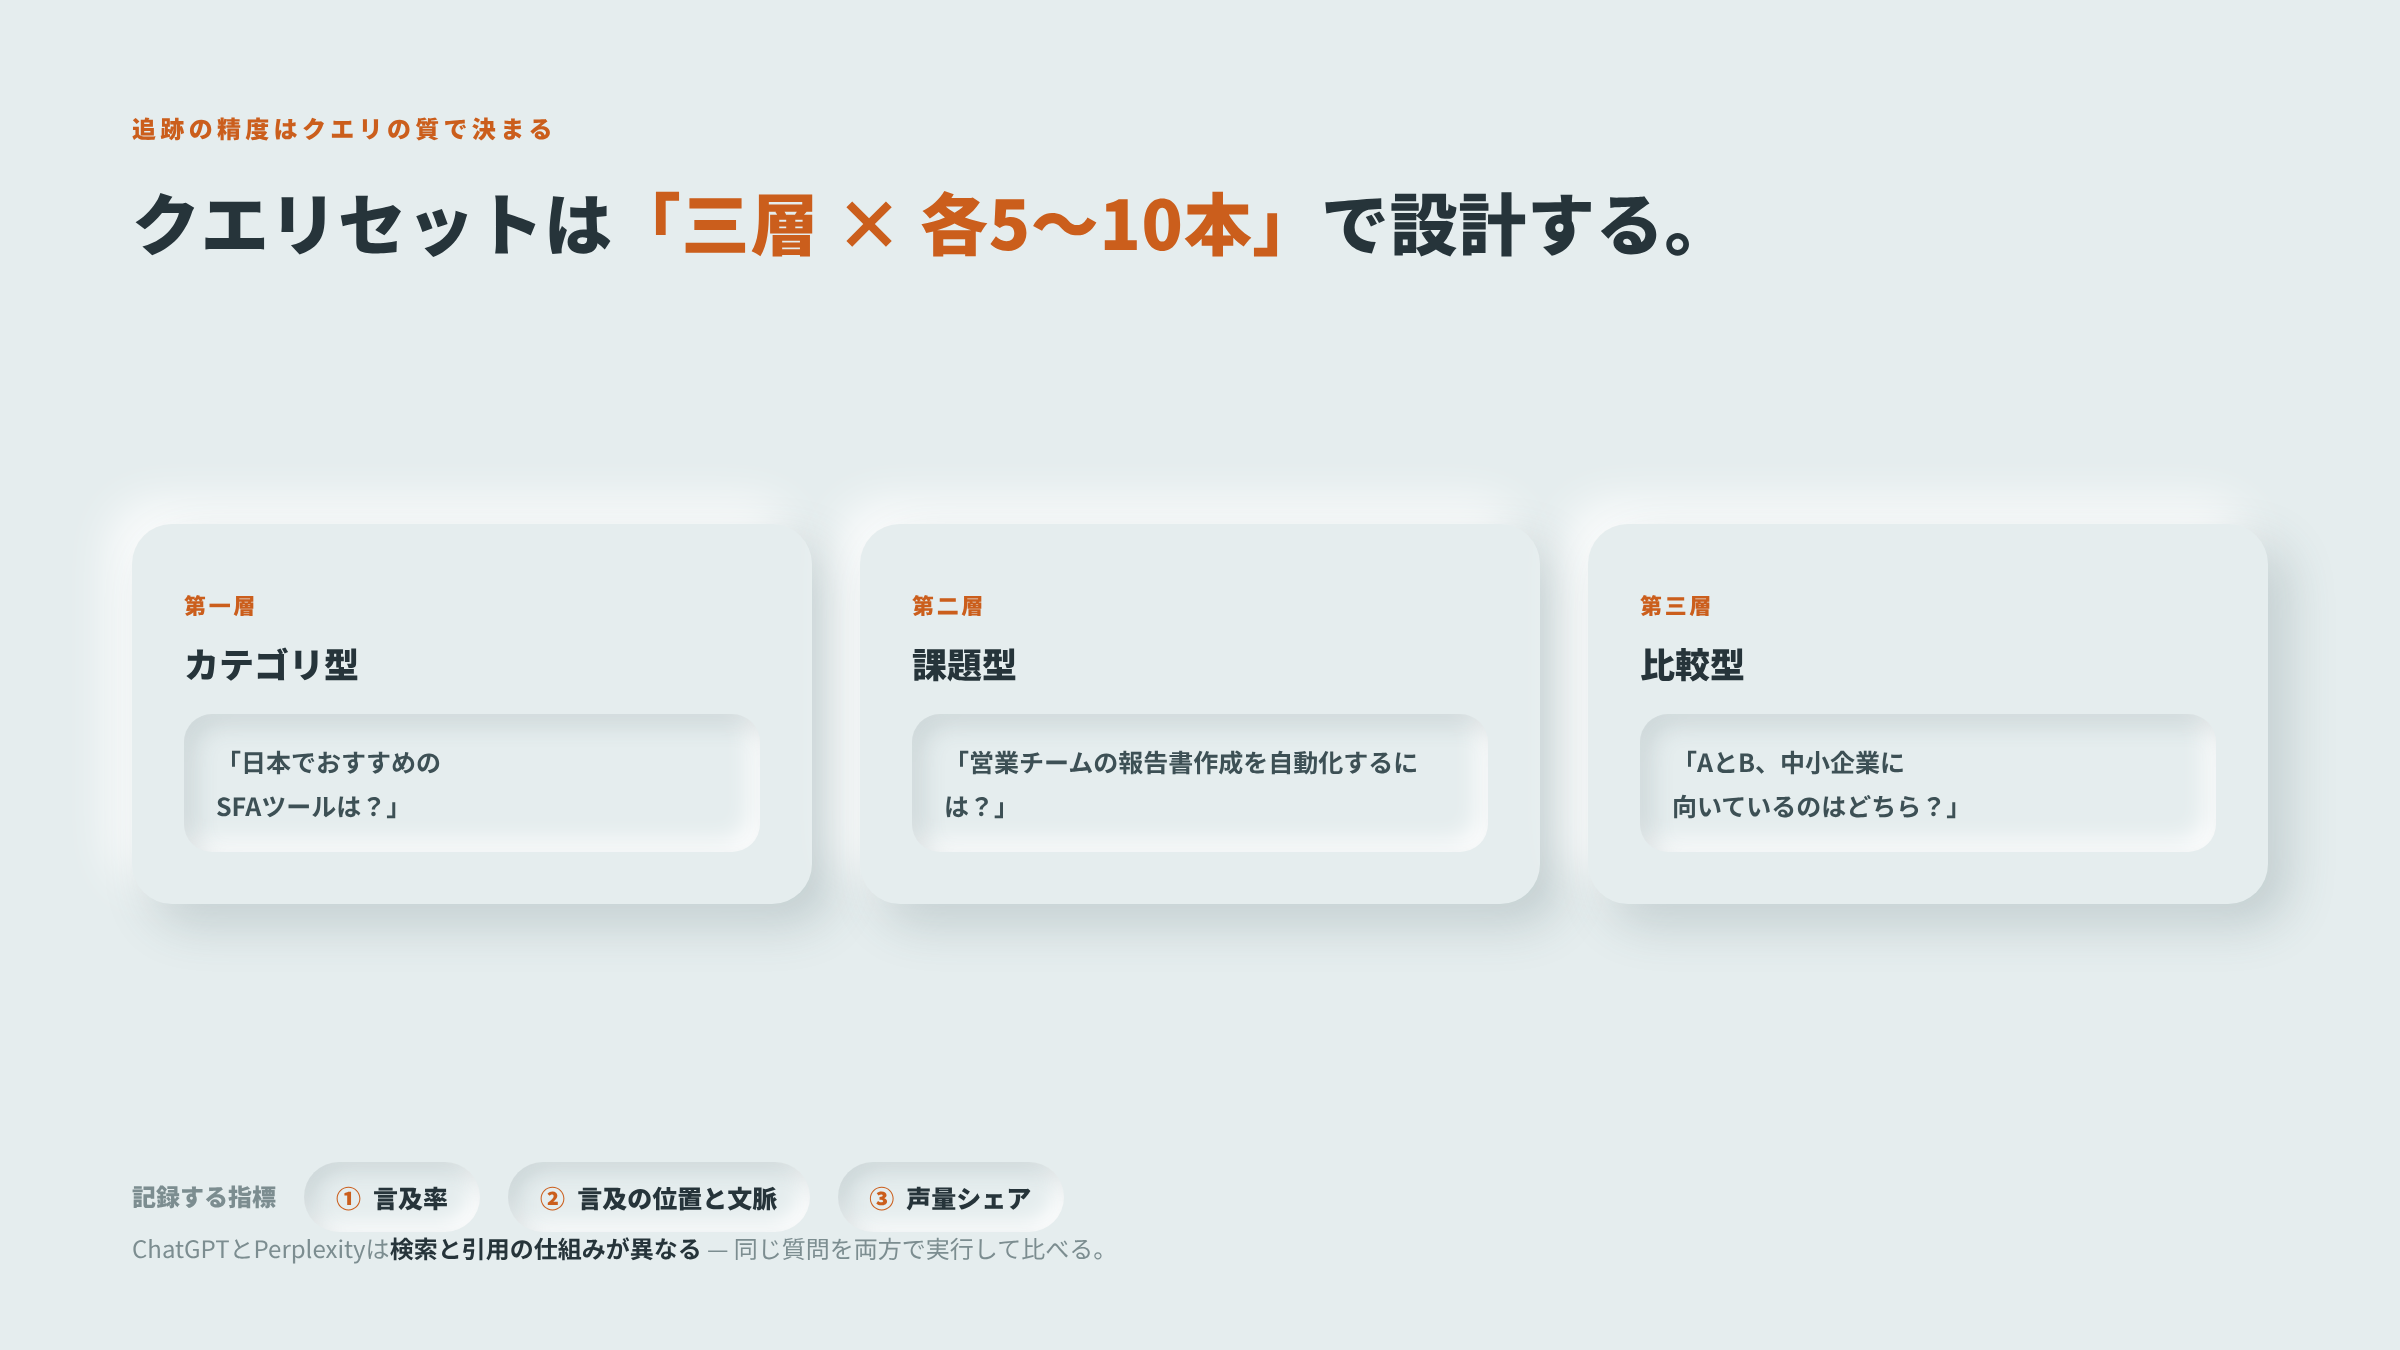
効果的な質問セットは三層で設計する。第一層は「カテゴリ型」——「日本でおすすめのSFAツールは?」「クラウド型会計ソフト比較」のように、購買検討時に実際に入力されるような質問だ。第二層は「課題型」——「営業チームの報告書作成を自動化するには?」のように、特定の課題を起点とする質問。第三層は「比較型」——「AとBどちらが中小企業に向いているか」のように、競合との比較を促す質問。
各層で5〜10本の質問を用意し、ChatGPTとPerplexityの両方で実行する。両者は検索と引用の仕組みが異なり、同じ質問でも引用されるページやブランドの扱いが変わることがあるからだ。ChatGPT・Gemini・Claudeの違いについての解説も参考になる。
記録すべき指標は次の三つだ。
- 言及率(Mention Rate):質問セット全体のうち、何パーセントの回答にブランド名が登場したか
- 言及の位置と文脈:回答の前半か後半か、推薦されているのか比較の一項目なのか
- 声量シェア(Share of Voice):同じ質問で、競合ブランドと比べて何回言及されたか
手動追跡と専用サービスでは何が違うのか?
手動追跡は費用ゼロで始められるが、規模と再現性に限界がある。
担当者が毎週ChatGPTを開いて同じ質問を入力し、結果をスプレッドシートに記録する——この方法でも始めることはできる。問題は再現性だ。ChatGPTの回答は同じ質問でも毎回同じではなく、会話の流れやアカウントの設定、時期、モデルの更新によって変わる。手作業ではこうした条件を揃えにくく、週ごとのデータを比べにくい。
専用の追跡サービスは、同じ質問を同じ市場・言語の条件で定期的に実行し、回答原文ごと記録する。回答は毎回揺れるため、同じ質問を複数回取得してばらつきも確認できるサービスなら、比較の精度が上がる。時系列での言及率の変化、コンテンツ更新後の効果検証、競合との比較が数字でできるようになる。
Citadex は ChatGPT、Perplexity、Gemini、Claude、Copilot、Google AI Overviews、Google AI モードなど最大13のAIエンジンで、日本語を含む市場別に同じ質問を定期実行し、回答原文と引用元を記録します。管理画面は日本語に対応し、無料プラン(500クレジット、カード登録不要)から試せます。料金は Pro 月額6,390円、Business 月額21,807円(税込)。ChatGPTがあなたのブランドを推薦しているかを追跡するツールの詳細(英語)もあわせて参照されたい。
手動と専用サービスの違いをまとめると次の通りだ。
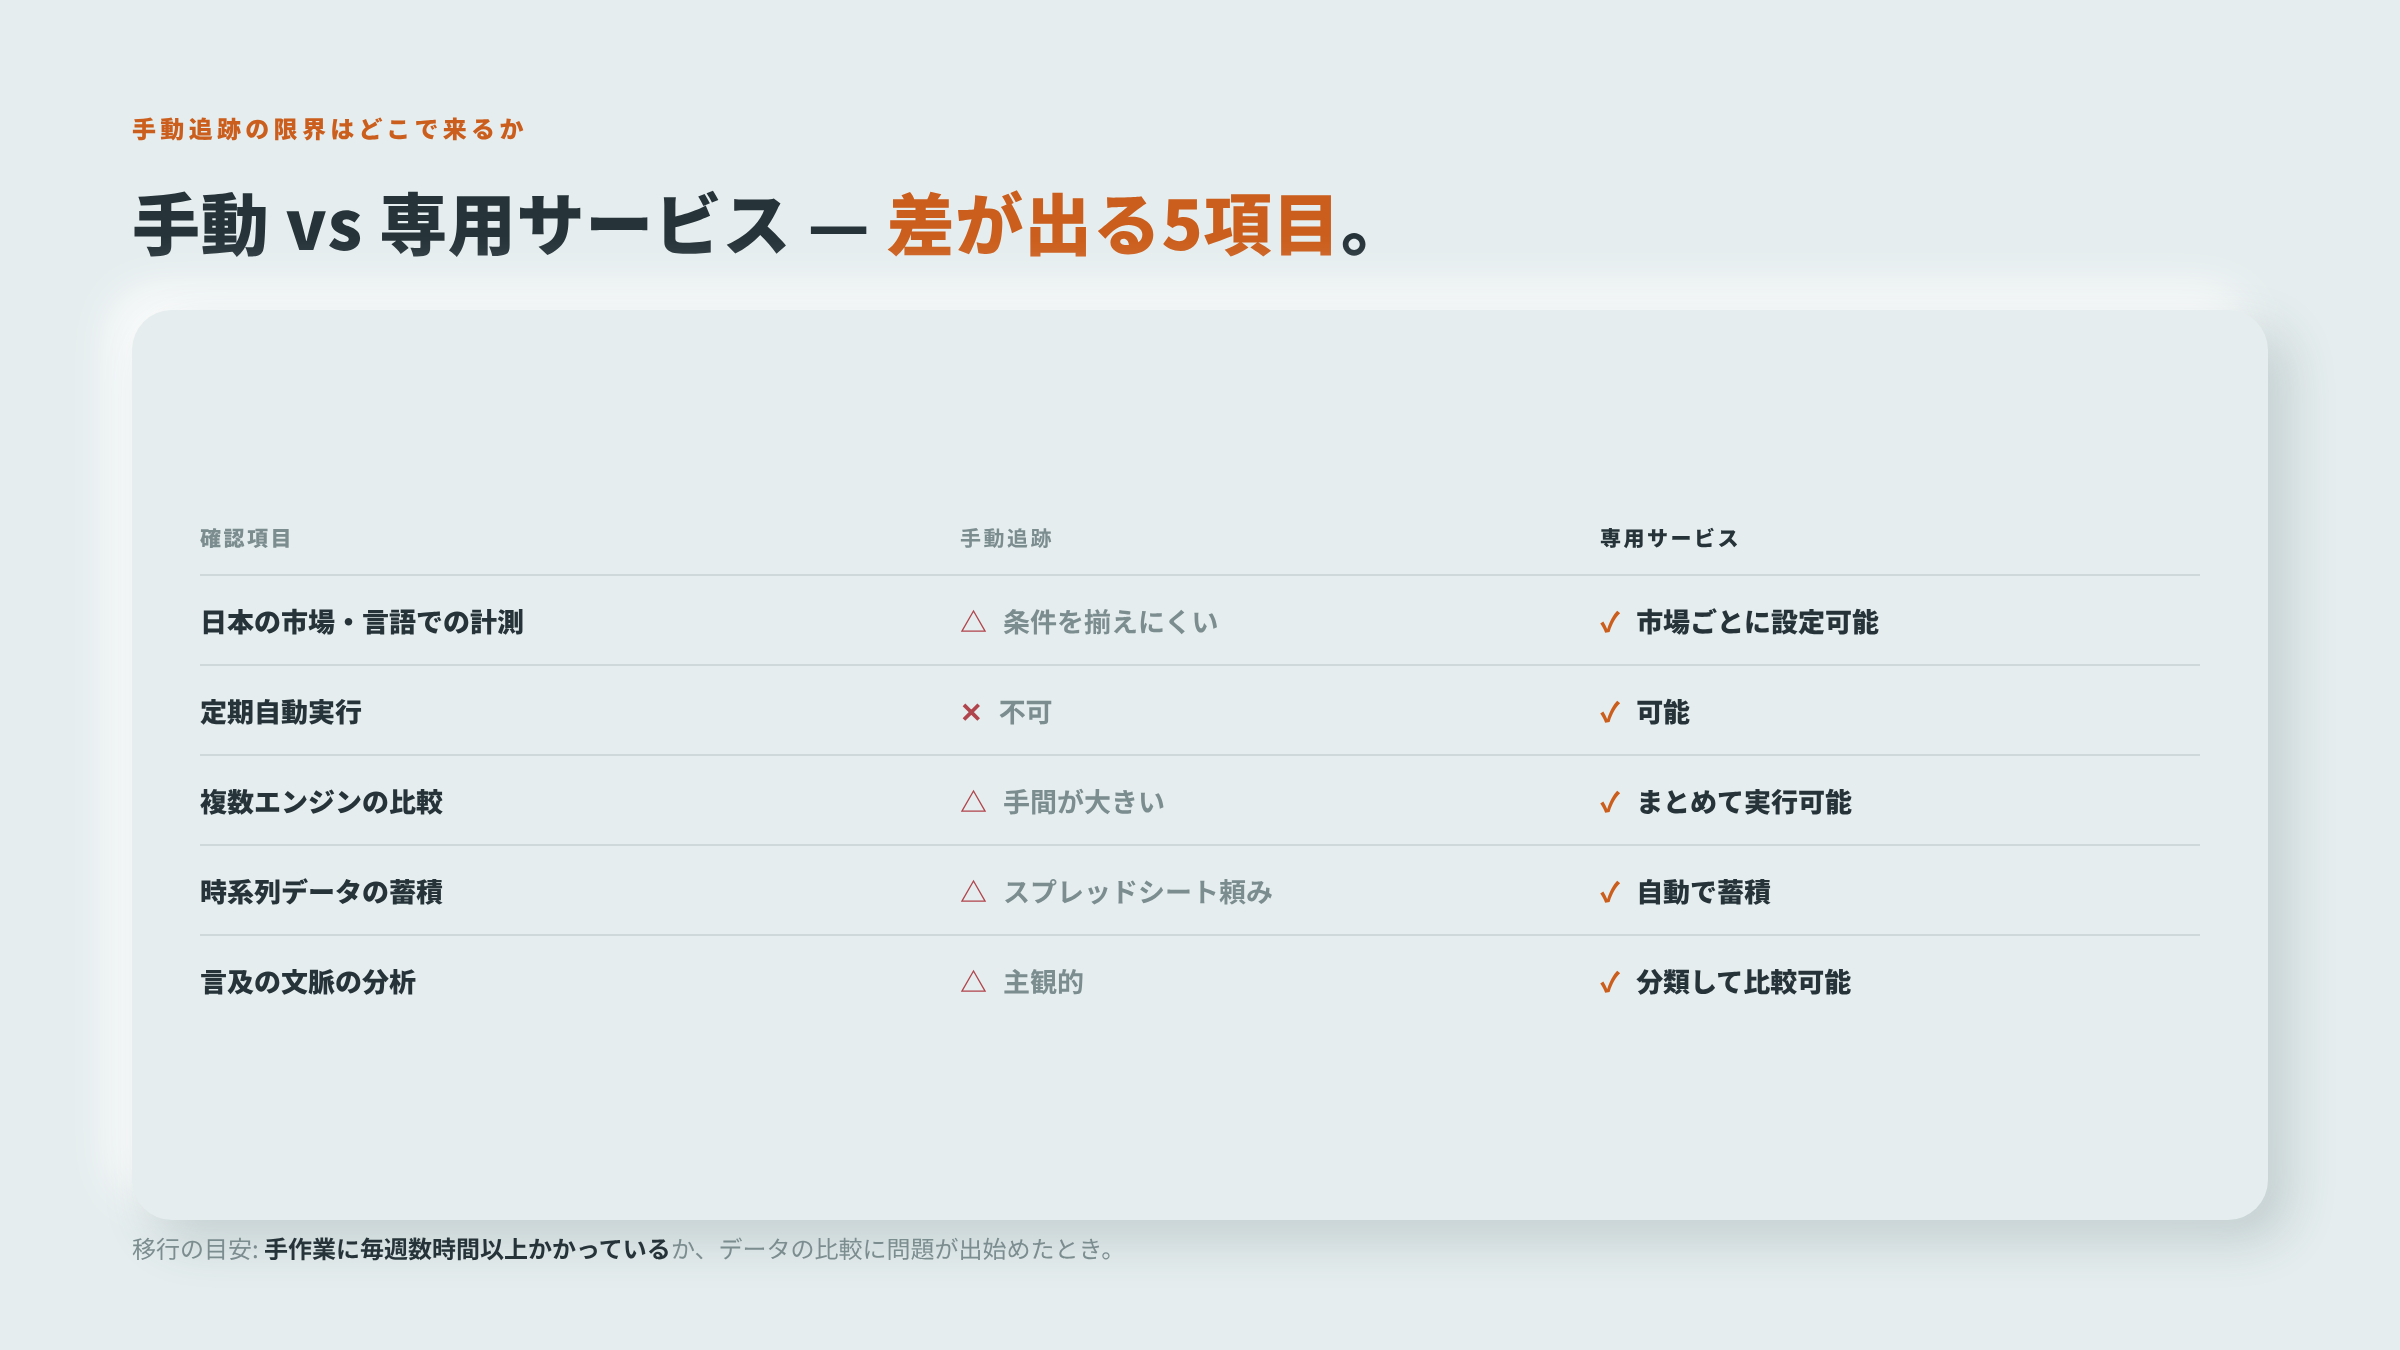
| 確認項目 | 手動追跡 | 専用サービス |
|---|---|---|
| 日本の市場・言語での計測 | 条件を揃えにくい | 市場ごとに設定可能 |
| 定期自動実行 | 不可 | 可能 |
| 複数エンジンの比較 | 手間が大きい | まとめて実行可能 |
| 時系列データの蓄積 | スプレッドシート頼み | 自動で蓄積 |
| 言及の文脈の分析 | 主観的 | 分類して比較可能 |
どのような仕組みでブランド言及の文脈を評価できるか?
言及の「あり・なし」だけでは不十分で、どう語られているかの評価が長期戦略には欠かせない。
文脈とは、言及がどのような意味合いで行われたかを指す。「Aはコスト重視の企業向け」「Bは大企業向け」のように語られる場合、それが自社の打ち出したい位置づけと一致しているかを確認する必要がある。AIエンジンが参照するページの多くは比較記事・レビューサイト・ユーザーの投稿であるため、そこでの語られ方が回答の文脈をつくる。
実務的には、各回答での言及を「推薦」「比較の一項目」「言及のみ」「否定的」の四つに分類し、週ごとの変化を追うとよい。たとえば、あるSaaSブランドが「中小企業向けのCRM」の質問で毎回「価格は高いが機能が豊富」と語られているなら、ウェブ上のレビューがその方向に偏っていることを示唆する。
この評価をするには、追跡ツールが「ブランド名が含まれているか」を検出するだけでなく、言及された文の前後を回答原文ごと保存し、分類できる必要がある。
追跡データをコンテンツ戦略にどう接続するか?
追跡で得たデータは、コンテンツ改善の優先順位づけに直結させて初めて価値を持つ。
言及率が低い質問カテゴリが見つかったら、次は「そのカテゴリに答える日本語のページがウェブ上に十分あるか」を確認する。AIエンジンの回答は取得できるページに依存するため、空白地帯があれば言及されない。逆に、競合が多く言及されている質問では、AIが引用しているページ(プレスリリース、note の記事、業界の比較記事など)を特定し、自社が載っていないものを洗い出せる。
たとえば、ある質問で競合が常に先に言及されるなら、AIが引用している比較記事に競合だけが載っていないか、競合が PR TIMES で事例を発表していないかを調べ、そのギャップを埋める——という具体的な行動につながる。
効果の検証は、コンテンツ公開後4〜8週間の言及率の変化を目安に行う。AIエンジンが新しいページを取り込むまでには時間差があるため、すぐの効果を期待せず、中期的な傾向で判断するのが正確だ。
AIエンジンにブランドを言及させるための戦略的アプローチ(英語)については、こちらの記事が詳しい。
追跡の頻度と運用設計はどう決めるべきか?
追跡頻度が低すぎると変化の原因を特定しにくく、高すぎると費用と手間が増える。
実務上は、週次または隔週の追跡サイクルが扱いやすい。週次であれば、コンテンツ更新・PR・プレスリリースなどの施策と結果を結びつけやすい。月次では変化の粒度が粗くなり、原因を特定しにくい。
運用で注意したいのはモデルの更新だ。ChatGPTやPerplexityは定期的にモデルを更新しており、更新の前後で同じ質問の結果が変わることがある。追跡ログには実行日時だけでなく、使ったエンジン(例:エンジン名と、分かる範囲でモデル名)も記録しておく。これを怠ると、施策の効果ではなくモデル変更による変動を、施策の成果と誤って解釈してしまう。
質問セットは固定せず、四半期ごとに見直すことを勧める。ユーザーの検索行動は変わり、新しいカテゴリや言葉が生まれる。日本語では業界用語の変化(例:「DX推進ツール」という表現の定着)が質問の変化に表れるため、追跡する質問自体を定期的に更新しないと、実際のユーザー行動から離れた指標を追うことになる。
追跡結果をどのように組織内で活用・共有すべきか?
追跡データは、使う部門に合わせて解釈・提示する必要がある。
マーケティングチームにとっての主要指標は言及率と文脈だが、経営層への報告では「競合との露出差」として示すほうが伝わりやすい。「ChatGPTで競合Xが言及される頻度は自社の2倍だ」と具体化すると、コンテンツ投資の必要性が明確になる。
製品チームへの共有も重要だ。AIエンジンが自社を「機能Aが弱い」という文脈で語っているなら、ウェブ上のレビューがその評価をつくっている。製品チームがその情報を受け取ることで、機能改善の優先順位や伝え方の見直しにつながる。
レポートは、質問カテゴリ別・エンジン別・期間別の三軸で整理すると、部門ごとに見たい切り口で参照しやすい。集計値だけでなく、個別の質問と実際の回答原文の一部を添えると、数字が実感を伴った議論につながる。
日本語の質問におけるAIエンジンのブランド追跡は、まだ多くの企業にとって手つかずの領域だ。AIエンジンが情報収集の主要な入口になりつつある今、この仕組みを早く整えたチームが、日本語市場でのブランド認知を先行して築ける可能性が高い。最も重要なのは、完璧な仕組みを一度に作ることではなく、まずシンプルな質問セットを定期的に実行する習慣をつくることだ。
よくある質問(FAQ)
Q: ChatGPTとPerplexityではブランド追跡の方法が異なりますか?
はい。両者は検索と引用の仕組みが異なるため、個別に計測する必要があります。Perplexityは基本的にウェブ検索を使い、引用元を明示しますが、ChatGPTはウェブ検索を使うかどうかで挙動が変わります。同じ質問を両方で実行すると、引用されるページやブランドの登場頻度が異なることが多く、その差自体が分析の対象になります。追跡ツールはエンジンごとに結果を記録し、比べられるようにしておくことが重要です。
Q: 日本語クエリと英語クエリで同じブランドの言及率が異なるのはなぜですか?
主な原因は三つあります。第一に、日本語で質問するとAIが内部で行う検索も日本語になりやすく、日本語のページが回答の材料になります。第二に、日本語の回答で引用されるサイトの顔ぶれ(PR TIMES、note、比較記事など)が英語とは大きく異なります。第三に、ブランド自体の日本語コンテンツが英語に比べて少ない場合が多いためです。これらが重なると、英語では頻繁に言及されるブランドが、日本語の質問ではほとんど登場しないという現象が起こります。
Q: ブランド言及の追跡はどのくらいの頻度で実行する必要がありますか?
週次または隔週が実務上の目安です。月次では変化の原因を特定しにくく、日次では回答の揺れが大きく出やすくなります。コンテンツ更新やPR活動との関係を確かめるには、施策の前後を含む週次のデータがあると比較しやすくなります。モデルの更新時期も追跡ログに残しておくと、誤った解釈を防げます。
Q: 手動での追跡と専用サービスはどのように使い分けるべきですか?
追跡する質問が少なく(10本以内)、頻度も月次程度であれば、手動でも始められます。ただし、日本の市場・言語での計測、複数エンジンの比較、時系列データの蓄積、文脈の分類が必要になると、手動では限界が出てきます。手作業に毎週数時間以上かかっている、またはデータの比較に問題が出始めたときが、専用サービスを検討する目安です。
Q: 言及率を改善するために最も効果的なコンテンツの種類は何ですか?
AIエンジンが取得・引用しやすいのは、構造化されていて(見出し・箇条書き・比較表)、質問に直接答える形式のページです。日本語市場では、PR TIMES でのリリース、note での発信、AIがよく引用する業界の比較記事への掲載が、引用の機会を増やす実践的な方法です。自社ブログだけでなく、第三者のサイトでの紹介やレビューサイトへの登録も効果があります。
Q: AIエンジンの言及追跡はSEO指標と組み合わせて管理すべきですか?
組み合わせることを勧めますが、指標の意味は分けて管理する必要があります。SEOはURLの検索順位を扱い、AI回答の追跡は回答内での言及頻度・文脈・引用を扱います。両者は相関することも多いものの、必ずしも一致しません。検索順位が低いページがAI回答では頻繁に引用されることもあれば、その逆もあります。両方の指標を並べて見つつ、施策の効果測定は目的別に使い分けると、正確な分析につながります。
Q: Citadexは日本語クエリの追跡にどのように対応していますか?
Citadex は ChatGPT、Perplexity、Gemini、Claude、Copilot、Google AI Overviews、Google AI モードなど最大13のAIエンジンで、日本語を含む市場別に同じ質問を定期実行し、回答原文と引用元を記録します。言及率・引用元・競合比較の推移が残るため、コンテンツ施策の効果を数字で確認できます。管理画面は日本語に対応し、無料プラン(500クレジット、カード登録不要)から試せます。料金は Pro 月額6,390円、Business 月額21,807円(税込)です。